ITIL5 e le metriche del ciclo di vita: dove entra Kanban e dove serve l’intelligenza artificiale

Ho appena terminato di tenere un corso ITIL 5 Foundation. Mentre raccontavo le otto attività del nuovo ciclo di vita dei prodotti e dei servizi, a ciascuna era associato un elenco di metriche di successo, e continuavo a vedere passare metriche che conosco molto bene: sono quelle tipiche dei sistemi Kanban. Avrei voluto fermarmi a raccontare cosa dice il Kanban Maturity Model (KMM) su quelle misure. Chi segue un corso come questo spesso vorrebbe anche capire come si fa nella pratica, ma un corso ITIL deve attenersi al contenuto dell’esame e non è il luogo per approfondire la parte pratica. Allora provo a farlo in questo articolo, almeno per dare qualche spunto.

Un secondo punto mi ha fatto riflettere durante il corso. ITIL 5 collega l’intelligenza artificiale alla visione olistica, quella che in Kanban chiamiamo visione sistemica (Systems Thinking), e all’individuazione dei colli di bottiglia, e dice che i miglioramenti del flusso vanno concentrati proprio lì. È un buon punto di partenza. Io ci aggiungo dove applicarla concretamente: a monte del collo di bottiglia intasa ancora di più, a valle accelera qualcosa che non ne ha bisogno. In aula ho fatto un breve accenno al concetto, qui vorrei provare a spiegarlo meglio.

Cosa introduce ITIL 5

ITIL 5 introduce un modello di ciclo di vita di prodotti e servizi digitali con otto attività: Discover, Design, Acquire, Build, Transition, Operate, Deliver, Support. ITIL precisa che non vanno eseguite come un ciclo: dal punto di vista dell’organizzazione formano la catena del valore, cioè l’insieme delle attività che abilitano il valore. Ogni organizzazione ne include alcune o tutte e le combina, secondo il proprio contesto, nei flussi del valore (value stream).

La novità rispetto a ITIL 4 è che a ciascuna attività è associato un elenco di metriche chiave di successo. In ITIL 4 le metriche stavano nelle pratiche. Cycle time, wait time e lead time c’erano già, ma a livello di flusso e di pratiche, non di attività.

Guardando l’insieme delle metriche, alcune saltano all’occhio. La soddisfazione compare in tutte e otto le attività: quella degli stakeholder in sette, quella di clienti e utenti in Deliver e in Support. L’aderenza alla roadmap o alla strategia in sette. Un tempo esplicito compare in quattro: Design, Acquire, Build e Transition, a cui si aggiunge la velocità di ripristino in Support. Discover, Operate e Deliver non hanno nessuna metrica di tempo.

Le metriche e il Kanban Maturity Model

Le corrispondenze con il KMM sono molte.

Per la transizione ITIL misura il numero e l’impatto degli errori di transizione, cioè dei rilasci andati male. Un rilascio andato male genera rilavorazioni, e il lavoro che ne nasce nel KMM si chiama failure demand: la domanda che arriva perché la qualità iniziale non bastava.

Per la qualità ITIL misura specifiche, risorse e soluzioni. Nel KMM la qualità si misura sul risultato finale: la quota di richieste consegnate senza rilavorazione. Quando si registra una rilavorazione, occorre risalire a quali specifiche, risorse o soluzioni l’hanno generata.

Per Deliver e Support ITIL misura la performance rispetto agli SLA concordati. Nel KMM corrispondono la puntualità di consegna e gli impegni di servizio basati sui percentili di lead time.

Per la soddisfazione di stakeholder, clienti e utenti ITIL ha una misura in ogni attività. Nel KMM corrispondono gli indicatori di fitness for purpose, ricavati dai criteri con cui il cliente sceglie il servizio.

Poi in ITIL troviamo le metriche di tempo: design cycle time, acquire cycle time, building cycle, transition cycle e velocità di ripristino. Nel KMM le grandezze corrispondenti sono lead time e cycle time, che si leggono come percentili sulle rispettive curve di distribuzione.

Cosa ITIL 5 dice sul livello operativo

ITIL 5 fornisce la cornice concettuale, il modello di ciclo di vita e i principi guida per orientare le decisioni, e lascia il dettaglio delle procedure operative ad altre fonti: le ITIL Practice Guide ufficiali, DevOps, PRINCE2 per il project management. Lo stesso ITIL dichiara che nessun framework da solo basta. Tratta anche il flusso, con la mappatura dei flussi del valore, e usa le metriche di tempo per individuare colli di bottiglia e ritardi.

Su Kanban dice due cose. Lo definisce come un metodo per visualizzare il lavoro, individuare blocchi e conflitti di risorse e gestire il lavoro in corso. E cita le Kanban board tra gli strumenti per dare visibilità agli stakeholder. Non compaiono né il funzionamento pull né i limiti al lavoro in corso. A mio avviso la rappresentazione che ITIL offre di Kanban è semplificata, come già scrivevo a proposito di ITIL 4: il metodo è molto più ricco.

Io propongo Kanban per governare e gestire i flussi. Per governare i flussi intendo applicare le pratiche e i principi del metodo Kanban, come specificati nel Kanban Maturity Model. Nel KMM il verbo governare si riferisce alle policy, che regolano il comportamento di persone e team, mentre il flusso di lavoro si gestisce. Io uso i due verbi insieme: le policy governano, e il lavoro scorre e si gestisce dentro quei confini.

Dalle metriche alla pratica

Prendiamo per esempio i rilasci andati male. In ITIL si misura il numero e l’impatto degli errori di transizione. In Kanban ragioniamo per work item, che attraversano il flusso. Se un work item arriva al rilascio e il rilascio va male, viene conteggiato e nasce un nuovo work item, marcato come failure demand: un rifacimento di qualcosa che era già stato fatto. Così facendo sappiamo in ogni momento quanta percentuale complessiva del lavoro è costituita da rilavorazioni.

Quanto possono pesare in percentuale le rilavorazioni? In Kanban: Successful Evolutionary Change for Your Technology Business, David Anderson riporta il caso di un team che spendeva il 90% della capacità disponibile nella correzione di difetti. Un flusso così è intasato da lavoro che nasce da lavoro già fatto male, e le nuove richieste aspettano.

Nelle organizzazioni più mature le rilavorazioni contano contro il limite del lavoro in corso: se ce ne sono troppe, non entra nuovo lavoro finché i problemi di qualità non sono stati risolti. I dati su difetti e rilavorazioni si guardano poi nelle revisioni periodiche, dove si decide cosa fare per ridurli.
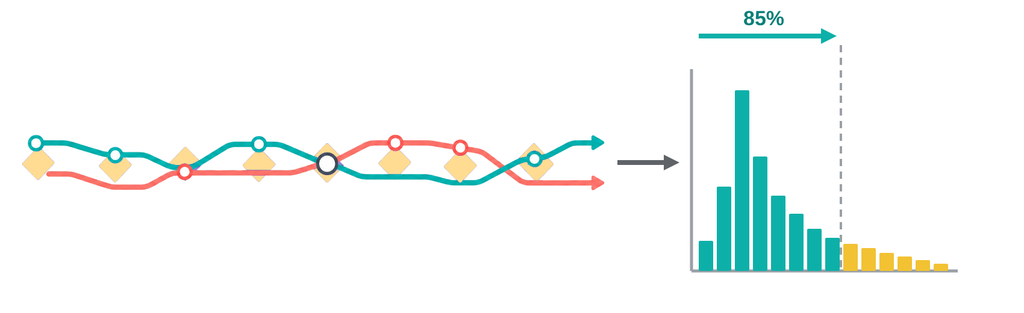
Passiamo alla performance rispetto agli SLA concordati. In Kanban lo SLA si costruisce partendo dai dati: si misurano i lead time dei lavori consegnati e se ne costruisce la curva di distribuzione. Dalla curva si leggono i percentili e, in base al percentile opportuno, si definisce la service level expectation (SLE): entro quanti giorni consegno e in quale percentuale di casi. L’85° percentile è il riferimento abituale, ma non è una regola: se un ritardo costa molto, conviene salire. Sulla base dello SLE definito si concorda lo SLA con il cliente in modo realistico.

Le metriche di tempo che ITIL associa alle attività, cioè design cycle time, acquire cycle time, building cycle e transition cycle, misurano ciascuna un singolo passaggio. ITIL ha poi una misura dell’intero flusso del valore, il lead time, dall’avvio alla consegna, e indica le otto attività come un buon punto di partenza per mappare i flussi. ITIL non dice però da dove parta il lead time.

Il KMM lo precisa, e parla dello stesso oggetto: quello che ITIL chiama flusso del valore, nel KMM è il workflow. Il customer lead time parte dalla richiesta accettata del cliente, il system lead time dalla presa in carico del lavoro da parte del team, ed entrambi arrivano alla consegna. Quando si applica Kanban si misurano sia le metriche end to end sia quelle dei singoli passaggi, e anche le attese, e in base a queste misure si ragiona su come ottimizzare il flusso.

Un passaggio può avere un buon tempo di ciclo e il cliente aspettare comunque a lungo, perché nel tempo di ciclo non ci sono le attese tra un passaggio e l’altro. L’esperienza dice che le attese sono la parte prevalente del lead time, e di diversi casi ho scritto anche su questo blog. Per questo si lavora sulle attese: limitando il lavoro in corso, riducendo code e buffer, gestendo meglio blocchi e dipendenze.

Lo stesso vale per la velocità di ripristino del servizio, che in ITIL compare in Support. È il lead time della gestione degli incidenti, e come ogni altra metrica di tempo si misura con la distribuzione, si legge con i percentili e si trasforma in uno SLE.

Resta la soddisfazione di stakeholder, clienti e utenti, che ITIL misura in tutte e otto le attività. Nel KMM non la si misura chiedendola in astratto. Si parte dai criteri con cui il cliente decide se richiedere il servizio, o dalle fonti della sua insoddisfazione, e da lì si ricavano gli indicatori da misurare: tempi di consegna per classe di servizio, quota di richieste consegnate senza rilavorazione, costo.

È quello che facciamo in continuazione con le aziende con cui collaboro. Partiamo dalle fonti di insoddisfazione, che mi raccontano i clienti. Quando abbiamo messo a posto il servizio, verifichiamo se quelle fonti sono state risolte. Gli indicatori non sono necessariamente solo quelli classici di Kanban: dalle fonti di insoddisfazione possono emergere altri aspetti da misurare, e li misuriamo. In questo modo la fitness for purpose diventa la sintesi di tutte le metriche, classiche e no.

L’intelligenza artificiale: dove serve e dove no

ITIL 5 dedica molto spazio all’intelligenza artificiale, e la collega alla visione olistica e all’individuazione dei colli di bottiglia. Dice anche di concentrare i miglioramenti del flusso proprio sui colli di bottiglia, e di ottimizzare il flusso prima di automatizzarlo. È un buon punto di partenza.

Una volta definito il flusso, si misura e si individua il collo di bottiglia, ed è lì che va applicata l’AI. Se la si applica a monte, il lavoro si accumula davanti al collo di bottiglia e il lead time peggiora. Se la si applica a valle, il lead time non cambia in modo apprezzabile, e può essere anche uno spreco: si accelera una stazione di lavoro che è già più scarica del collo di bottiglia. Prendiamo uno sviluppo software: se l’AI fa scrivere il codice più in fretta, ma il collo di bottiglia, a monte, è la risposta del cliente sui requisiti poco chiari, il lavoro accelerato resta in attesa. Non è cambiato nulla.

C’è poi un secondo ragionamento. Spesso il lavoro è fatto per lo più di attese, e accelerare il lavoro effettivo, come fa l’AI quando velocizza un compito, cambia poco il lead time. Ne ho scritto in un articolo recente, e lì la domanda diventa un’altra: come usare l’AI per ridurre le attese.

Conclusione

Sono partito da ITIL 5, che dice cosa misurare per ciascuna attività del ciclo di vita e rimanda ad altre fonti per il dettaglio operativo. Io propongo Kanban per governare e gestire i flussi, e le metriche sono il punto da cui si comincia. I rilasci andati male diventano failure demand, gli SLA nascono dalla distribuzione dei lead time, la soddisfazione si ricava dalle fonti di insoddisfazione di chi usa il servizio, e le metriche di tempo si leggono su tutto il flusso, non solo su un singolo passaggio.

Anche per l’intelligenza artificiale vale lo stesso ragionamento: serve dove c’è il collo di bottiglia, non dove il lavoro è già veloce. E resta necessario qualcuno che gestisca il sistema di lavoro, AI compresa.

Bibliografia

  1. ITIL® Foundation, Version 5, manuale ufficiale, e ITIL® (Versione 5) Glossario principale, v5.1, luglio 2026, PeopleCert.
  2. David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention, 2nd Edition, Kanban University Press, 2021.
  3. David J. Anderson, Kanban: Successful Evolutionary Change for Your Technology Business, Blue Hole Press, 2010.
Come funziona Kanban: dalla stima alla previsione, quando il fornitore sono io

Nell’articolo precedente ho raccontato come prendere le misure a un fornitore lento: misurare io il tempo che passa tra la mia richiesta e la sua risposta, quella che chiamo ‘metrica reciproca’, e regolarmi di conseguenza. Chiudevo con un’osservazione: il livello di servizio che dichiaro a valle deve tenere conto di quello che so del mio fornitore.

Resta però una domanda: quale livello di servizio dichiaro, io? Perché a valle il fornitore sono io. E il mio cliente, che io mi misuri o no, prima o poi la metrica reciproca la prende a me. Esattamente come io l’ho presa al mio fornitore.

Prendere le misure a me stesso

Quando un cliente chiede “per quando?”, di solito si tende a rispondere con una stima. Si guarda il lavoro, si valuta quanto è complicato, si pensa a com’è andata l’ultima volta e si ipotizza una data. È un’opinione, magari esperta, ma resta un’opinione. Una previsione funziona in un altro modo: non guarda il singolo lavoro, guarda come sono andati tutti i lavori simili. Non è un’opinione, è statistica.

Per fare questo lo strumento lo conosciamo già: è la stessa curva di distribuzione del Lead Time che ho costruito per il fornitore, solo che questa volta riguarda la parte del servizio che gestisco io. Con un’avvertenza su cosa misurare, perché è qui che ci si inganna più facilmente.

Il Kanban Maturity Model (KMM) distingue il Customer Lead Time, che parte da quando il cliente fa la richiesta, dal System Lead Time, che parte da quando io la prendo in carico. In mezzo c’è l’attesa all’ingresso: la richiesta è arrivata, ma nessuno ci sta ancora lavorando. Quell’attesa tendo a non vederla, perché per me il lavoro non è ancora cominciato. Il cliente invece la subisce per intero. Se misuro solo il System Lead Time, la mia previsione è strutturalmente ottimistica e il cliente aspetta sistematicamente più di quanto dicano i miei dati.

“I dati non li abbiamo”

Quando ne parlo nelle aziende arriva quasi sempre un’obiezione: “bello, ma i dati non li abbiamo”. In realtà ci sono quasi sempre, solo che non vengono usati. Ogni lavoro chiuso ha lasciato una traccia: una data in cui è stato chiesto e una in cui è stato consegnato, in un sistema di ticketing, in una mail, in un registro, a volte in un foglio Excel che qualcuno compila per abitudine. Non servono strumenti sofisticati per cominciare, serve la disciplina di raccogliere i dati. E, come abbiamo visto nel precedente articolo, se il sistema è stabile una trentina di misurazioni bastano per avere un primo quadro affidabile.

“Ma ogni lavoro è diverso”

La seconda obiezione che ricevo in azienda è più radicata: “il nostro lavoro non si presta, ogni cliente ha esigenze uniche, ogni progetto è un caso a sé”. È vero solo in parte. Il lavoro davvero unico esiste, ma è molto meno di quanto ci piace pensare. Il resto è fatto di attività che ripetiamo ogni settimana, solo che non le tracciamo, e quello che non vediamo ci sembra imprevedibile per definizione.

Di solito il lavoro non è tutto diverso: è di pochi tipi diversi. E i dati, curiosamente, lo mostrano da soli. Il KMM osserva che quando la distribuzione del Lead Time ha più picchi, in genere è perché dentro ci sono più tipi di lavoro mescolati. La risposta, quindi, non è rinunciare a misurare perché “tanto è tutto diverso”, ma separare i dati per tipo e costruire una curva per ciascuno. Tre o quattro tipi di lavoro diventano tre o quattro distribuzioni, e tre o quattro previsioni, ognuna sufficientemente affidabile per il suo tipo.

Dalla distribuzione allo SLE

Dalla distribuzione nasce il livello di servizio che posso dichiarare al cliente, lo SLE (Service Level Expectation): entro quanto tempo consegno, e in quale percentuale di casi. Perché sia una promessa e non un azzardo, però, servono due condizioni.

La prima è che la coda sia sottile, cioè che il rapporto tra il 98° percentile e la mediana stia sotto 5,6. Se la coda è grassa, qualunque numero dichiari è fragile: prima o poi arriva il caso che va lunghissimo e smentisce tutto. In quella situazione il primo lavoro non è promettere, è accorciare la coda statistica.

La seconda è scegliere il percentile giusto. L’85° è il riferimento comune per i servizi, sei volte su sette, ma non è una regola che vale sempre. Dipende da quanto costa al cliente un ritardo: se il ritardo costa molto, conviene salire.

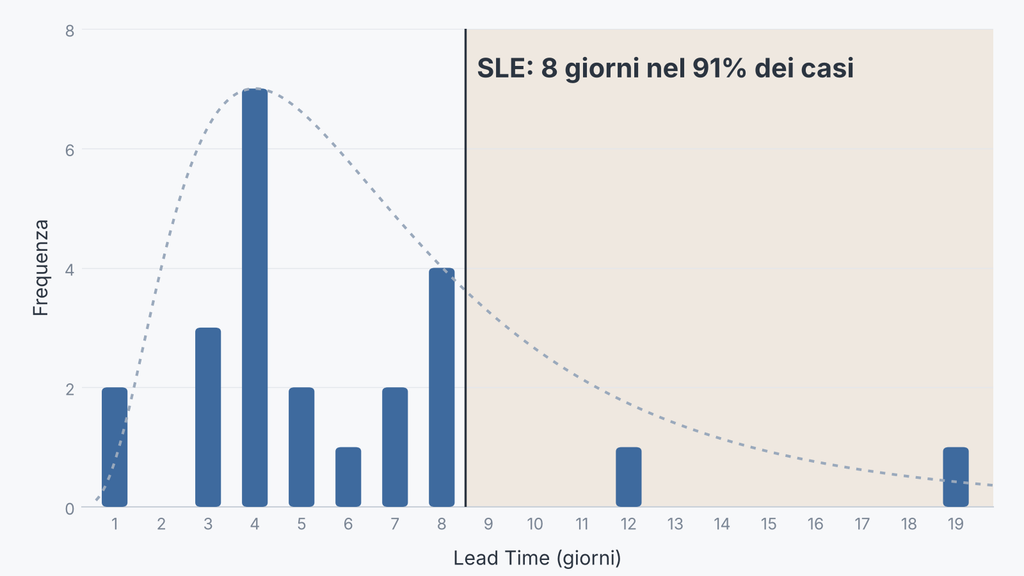
Distribuzione del Lead Time dell’onboarding dopo il primo mese

Un buon esempio di quanto descritto è il caso dell’onboarding di Grow, di cui parlo nell’articolo Migliora le tue risorse umane con Kanban: Kanban in HR – Scaling Kanban in an HR department at Grow (Italy) (case study in inglese). Quando abbiamo cominciato a misurare, il Lead Time andava da 1 a 96 giorni: una coda grassa, su cui nessuna promessa poteva essere affidabile. Non abbiamo dichiarato niente. Siamo intervenuti su uno dei colli di bottiglia, la firma digitale del contratto, e in un mese la coda si è accorciata fino a diventare sottile (19 giorni), con una distribuzione dei tempi di onboarding come nell’immagine. Solo a quel punto abbiamo dichiarato ai reparti richiedenti uno SLE: 8 giorni nel 91% dei casi.

Abbiamo tenuto il percentile più alto dell’85° perché un ritardo nell’onboarding non era un semplice disagio: significava persone al lavoro senza un contratto firmato, con il rischio di sanzioni. Lo stesso servizio, con un costo del ritardo più basso, avrebbe potuto reggersi su un percentile diverso.

Cosa vuole davvero il cliente

Si pensa spesso che il cliente voglia tutto e subito, e che l’unico modo per farlo contento sia promettere tempi brevi. In realtà quello che spesso cerca è un’altra cosa: risposte oneste e previsioni affidabili, con cui fare a sua volta le sue previsioni.

È il meccanismo dell’articolo precedente, visto dall’altra parte del tavolo. Il mio SLE diventa il dato su cui il mio cliente pianifica, esattamente come lo SLE del mio fornitore era il dato su cui pianificavo io. Una data detta con sicurezza, che poi slitta, magari più volte, non gli serve a niente: lo costringe a ripianificare ogni volta. Una previsione affidabile con una probabilità dichiarata invece gli permette di regolarsi. La catena regge solo se ogni anello è onesto e affidabile, e io sono uno degli anelli.

Conclusione

Non è vero, quindi, che non posso promettere niente di affidabile. Come minimo posso misurarmi, con gli stessi strumenti con cui misuro il fornitore, e sapere cosa posso dichiarare. Posso separare i tipi di lavoro invece di nascondermi dietro il “è tutto diverso”, accorciare la coda dove serve prima di promettere, e scegliere il percentile in base a quanto costa davvero un ritardo. E posso dare al mio cliente esattamente quello che io chiedo al mio fornitore: una previsione onesta.

Al giorno d’oggi, poi, c’è una nuova tentazione, più forte che mai: usare l’AI e lasciare che sia lei a fare le previsioni al posto nostro. Ma se il lavoro non è tracciato, l’AI una risposta la dà comunque, sicura e ben presentata, solo che non ha fondamento. È una stima come quella descritta più sopra, ma quando esce da un sistema automatico con un numero e un grafico, smette di sembrare un’opinione e nessuno la mette più in discussione. Decidere cosa misurare e come resta una scelta umana, come ho spiegato nell’articolo Perché collegare l’AI ai vostri dati di flusso non basta.

Quest’ultimo tema è così importante che ho deciso di dedicargli un podcast, che prenderà il via il prossimo mese di novembre. Restate sintonizzati!

Bibliografia

  1. David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention – 2nd Edition, Kanban University Press, 2021

Come funziona Kanban: se il fornitore è lento, non è vero che non posso farci niente

Una frase che mi capita spesso di sentire è più o meno questa: “Noi potremmo organizzarci meglio e rendere prevedibile il nostro lavoro, ma i tempi di certe operazioni dipendono dagli altri. Non possiamo farci niente.”

Ogni volta che l’ho sentita ho pensato che avrei dovuto scrivere questo articolo. Perché non è vero che non ci si può fare niente: si può fare qualcosa, e anche di abbastanza semplice.

Chiamo fornitore chiunque debba fare qualcosa per me senza che io ne abbia il controllo. Può essere un’azienda esterna, ma anche un collega di un’altra funzione.

Prima di tutto, misurare

Se dipendo da qualcuno che ci mette tanto tempo, la prima cosa da capire è cosa vuol dire quel “tanto”. Se il fornitore non mi dà le sue metriche, le prendo io: è quella che chiamo ‘metrica reciproca’. Misuro il tempo che passa da quando faccio la richiesta a quando ricevo la risposta, e lo faccio abbastanza a lungo da costruire una curva di distribuzione del Lead Time.

Non servono migliaia di dati. Se il fenomeno è consistente, cioè se i tempi restano più o meno sempre nello stesso range, siamo in quello che Taleb chiama Mediocristan. Il Kanban Maturity Model (KMM) offre una regola pratica per verificarlo: il rapporto tra il 98° percentile e la mediana deve stare sotto 5,6. In quel caso una trentina di misurazioni bastano per avere un quadro piuttosto affidabile.

Abbastanza spesso, a misure prese, scopro una cosa banale: il fornitore non è imprevedibile, è semplicemente più lento di quanto dichiara. E lo è in modo costante.

Decidere con i dati

Il riferimento abituale è l’85° percentile: sei volte su sette la risposta arriva entro quel tempo. Il KMM definisce il Lead Time proprio così: se so quando mi serve la consegna, il Lead Time è l’anticipo con cui devo fare l’ordine per aspettarmi di riceverla in tempo.

A questo punto confronto quel valore con il tempo di cui ho bisogno. Se la risposta mi serve più in là dell’85° percentile, la richiesta va in classe di servizio standard: la mando con il giusto anticipo e so che, storicamente, arriverà in tempo. È inutile sollecitare, ed è inutile sorprendersi ogni volta dei tempi lunghi. Li conosco.

Se invece mi serve prima, il rischio di andare lunghi è più alto di quello che posso permettermi, e la richiesta va segnalata come urgente. Più il tempo è stretto, più il rischio è alto, e la distribuzione mi dice esattamente quanto. L’urgenza però deve restare un’eccezione: se tutto arriva urgente, il fornitore smette di crederci. Per questo conviene giocare d’anticipo il più possibile.

Provare a pressare e poi misurare di nuovo

“Va bene, ma allora come facciamo?” A questo punto posso fare un esperimento: pressare il fornitore e vedere cosa succede alla distribuzione. Se si comprime e l’85° percentile rientra nel tempo che mi serve, ho trovato un pattern su cui contare: il pressing diventa strutturale e lo faccio di default. Se non si comprime, ho comunque imparato che quella leva non funziona.

In ogni caso devo continuare a misurare, perché il pressing cambia il sistema. E devo tenere a mente che, se i miei tempi si accorciano, forse sto solo passando davanti agli altri clienti del fornitore: io miglioro, il suo sistema no.

Le misure servono anche a valle. Se a mia volta devo garantire dei tempi a un cliente, interno o esterno, il mio livello di servizio atteso (SLE – Service Level Expectation) deve tenere conto di quello che so del mio fornitore. È inutile promettere cose che so già di non poter mantenere a causa di qualcun altro.

Un caso reale

Con un fornitore con cui c’è una buona collaborazione dovevamo chiudere un progetto. Il fornitore dichiarava di poter finire entro fine febbraio, e per farcela avrebbe dovuto rilasciare circa nove work item a settimana. Gli abbiamo preso le misure, ricostruendole da progetti passati: ne rilasciava tre, in modo piuttosto stabile.

Non potevamo triplicare il suo Throughput, così abbiamo triplicato il tempo e pianificato la consegna per fine aprile. A lui abbiamo continuato a indicare fine febbraio. Abbiamo misurato il Throughput e non il Lead Time, ma con un sistema stabile vale la Legge di Little e il risultato non cambia: circa tre mesi.

Il progetto si è chiuso, come previsto, a fine aprile. La scadenza più stretta non ha accelerato nulla: il fornitore ha tenuto il suo ritmo. Noi però siamo arrivati puntuali, perché avevamo pianificato sui suoi numeri e non sulle sue dichiarazioni.

Successivamente ho condiviso con lui, in modo trasparente, cosa avevamo misurato e cosa avevamo fatto. E lui ha cambiato approccio.

Conclusione

Quindi no, non è vero che non posso farci niente. Come minimo posso misurare, e sapere cosa posso promettere a mia volta. Poi posso giocare d’anticipo, sperimentare il pressing e vedere se cambia qualcosa. E posso portare i dati al fornitore, perché il suo sistema può migliorarlo solo lui.

Chi ha già un sistema Kanban strutturato può fare il passo successivo con le classi di dipendenza, di cui ho scritto nell’articolo Come funziona Kanban: gestire le dipendenze esterne con le classi di dipendenza.

Bibliografia

  1. David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention – 2nd Edition, Kanban University Press, 2021

L’intelligenza artificiale accelera il lavoro, ma il Lead Time è fatto per lo più di attese

Quando mi chiedono che lavoro faccio, e chi me lo chiede non ha chiaro perché serva un consulente per migliorare i flussi di lavoro, parto sempre dall’efficienza di flusso.

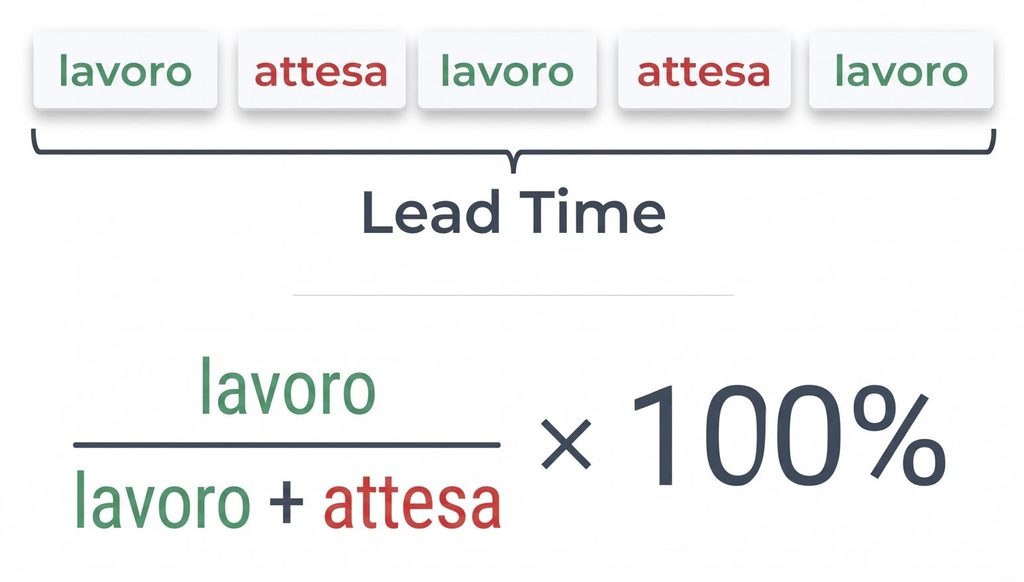
L’efficienza di flusso è il rapporto tra il tempo in cui si lavora effettivamente a un’attività e il tempo totale che passa dall’inizio alla fine di quella stessa attività, cioè il Lead Time. Nella pratica, di solito non si usa come indicatore operativo, perché non è semplice da calcolare. Si usano le pratiche del metodo Kanban, le quali, come risultato, aumentano l’efficienza di flusso. Comprenderne la dinamica, pur senza calcolarla, permette comunque di afferrare il senso del metodo Kanban.

Quando l’efficienza di flusso è bassa, cioè sotto il 15% secondo il Kanban Maturity Model (KMM), il margine di miglioramento sta soprattutto nell’eliminare i tempi di attesa. Il che si ottiene limitando il lavoro in corso, riducendo code e buffer e gestendo meglio problemi bloccanti e dipendenze, tutte pratiche Kanban. Anderson ne ha parlato in un recente keynote, che ho sintetizzato in un articolo. Qui voglio riprendere e approfondire questo specifico aspetto.

Il lavoro effettivo è inizialmente solo una piccola parte del tempo

Il Toyota Production System, precursore del metodo Kanban, ha messo al centro proprio questo: non far andare più veloci gli addetti all’assemblaggio dei veicoli, ma eliminare le attese che stanno intorno al lavoro vero e proprio.

Nel lavoro di concetto, knowledge work in inglese, il ragionamento è identico, con una differenza. La materia prima è l’informazione. Se si parte senza averla tutta e questa arriva un po’ per volta, ci si ferma ad aspettarla, si riparte, ci si ferma di nuovo.

Prendiamo lo sviluppo software. Si comincia a sviluppare e a un certo punto manca un requisito del cliente, perché non era chiaro in fase di analisi. Si chiede al cliente, poi ci si ferma e si aspetta. Quando si ha la risposta, si riprende a lavorare fino a quando si incappa in un altro requisito poco chiaro e ci si ferma di nuovo. E così via. Alla fine il software è pronto, lo si consegna al cliente per il test e si resta in attesa del suo feedback. Se si sommano le attese, nell’esperienza mia e di molti colleghi della community Kanban, queste costituiscono la parte largamente prevalente del Lead Time.

Andare più veloci non è la leva

Per questo, all’inizio di una consulenza, una delle prime cose su cui lavoro è smontare l’idea, diffusa, che l’efficienza si ottenga facendo lavorare più in fretta le persone.

Il punto è controintuitivo. Limitare il lavoro in corso significa che le persone si occupano di meno cose contemporaneamente. Nella mia esperienza questo le porta a ricavarsi il tempo per riflettere su come tagliare i tempi morti, e dopo un po’ il processo va più veloce, senza che nessuno debba affannarsi. Nelle organizzazioni di cui parlo nei miei case study ho visto riduzioni del Lead Time fino al 90%, risultati che sono analoghi a quelli riscontrati da colleghi della community.

Cosa c’entra l’intelligenza artificiale

A più di un lettore può essere venuto a questo punto il dubbio: ma cosa c’entra questo ragionamento con l’intelligenza artificiale? Oggi, nel lavoro di concetto, l’AI viene usata soprattutto per la produttività personale. Aiuta a scrivere un testo, a fare calcoli, a preparare un’analisi, a sviluppare codice, e ognuno di questi compiti si svolge più in fretta.

Ma applicare l’AI a queste attività risponde alla stessa logica del far andare più veloci le persone. Accelera il lavoro effettivo, che è la parte più piccola del Lead Time.

Un esempio numerico: supponiamo che il lavoro effettivo sia il 10% del Lead Time, quindi due giorni su venti, e che l’AI lo dimezzi. Il lavoro passa a un giorno, il Lead Time a diciannove giorni, con un miglioramento del 5%. Il 10% è un’ipotesi esemplificativa, in linea con una situazione sotto la soglia del 15% del KMM, che è l’ordine di grandezza da cui partono i casi che seguo. Il dimezzamento del lavoro effettivo è generoso, per cui nella realtà il miglioramento è probabilmente inferiore.

A fronte di un miglioramento di questa entità, il costo dell’AI può essere anche rilevante, come riferito nel keynote da Anderson. Tornando all’esempio del software: se l’AI fa scrivere il codice più in fretta, il collo di bottiglia resta la risposta del cliente, e il problema non è risolto.

Serve un uso sistemico dell’intelligenza artificiale

La domanda giusta è come si potrebbe usare l’AI per ridurre le attese, che sono ciò che incide davvero sul Lead Time. Personalmente, un uso sistemico di questo tipo non l’ho ancora visto.

Se e quando lo troveremo, otterremo più valore dall’investimento. Anche questo ragionamento conferma però un tema che ho già sollevato in miei articoli precedenti: serve qualcuno che pensi a come gestire il sistema di lavoro e gli strumenti, l’AI compresa. Questo compito non viene eliminato dall’intelligenza artificiale, e continua a essere necessario come lo è sempre stato.

Pillole di Kanban: Il paradosso del pendolare e l’illusione delle vecchie metriche

Per anni, il mio viaggio in treno verso l’ufficio di un cliente è stato il mio laboratorio personale di Kanban. Avevo costruito una metrica di Lead Time estremamente affidabile, un set di dati consolidati che mi permetteva di calcolare al minuto l’istante esatto in cui uscire di casa per essere puntuale, senza sprecare un solo secondo. Era il trionfo della prevedibilità.

Poi, come per tutti, il mondo è cambiato. Tra la pandemia e un’evoluzione delle mie attività professionali, ho iniziato a usare quasi esclusivamente l’auto. Recentemente, però, ho avuto l’opportunità di tornare alle vecchie abitudini e riprendere il treno. Convinto della solidità della mia esperienza passata, ho ripreso in mano i miei vecchi dati. Mi sono fidato di quella ‘verità’ storica per pianificare il mio arrivo.

Mentre camminavo verso la mia destinazione finale, riflettendo sul fallimento della mia pianificazione, ho iniziato a concepire questo articolo. Mi sono reso conto di aver commesso lo stesso errore che spesso rimprovero alle aziende con cui collaboro: ho agito basandomi su metriche scadute in un sistema che non è più lo stesso.

L’invecchiamento delle metriche: quando i dati diventano il tuo rischio

Il mio errore non è stato di calcolo, ma di contesto. Quelle metriche, che anni prima garantivano la mia puntualità, erano diventate inutili, anzi, pericolose. Le ferrovie sono cambiate: l’infrastruttura è meno affidabile, i guasti più frequenti. Quel giorno, un imprevisto tecnico mi ha causato un ritardo di 15-20 minuti, mandando in fumo la mia pianificazione.

Come Kanban Coach, parlo spesso di stabilità del processo. Una metrica non è una verità ontologica; è una fotografia di un sistema in un determinato stato di equilibrio. Se il contesto muta, che sia per una crisi globale o per un degrado strutturale, la metrica subisce un processo di obsolescenza (Metric Decay). Usare il Lead Time del 2019 nel 2026 è come navigare una costa rocciosa usando una mappa del secolo scorso. Il territorio è cambiato, e lo schianto è quasi certo.

Mediocristan vs. Extremistan: comprendere la natura del mondo

Per navigare l’incertezza, dobbiamo capire in quale dominio stiamo operando. Nassim Taleb distingue tra Mediocristan, dove le fluttuazioni sono scarse e seguono una distribuzione Gaussiana, prevedibile. Ed Extremistan, il regno degli eventi estremi, dove un singolo evento può invalidare ogni previsione.

Senza metriche fresche e aggiornate, perdiamo la capacità di distinguere tra questi due mondi.

Se non so più quanto sia affidabile il treno, non posso più permettermi il lusso dell’efficienza. Sono costretto a un enorme dispendio di capacità residua: per essere sicuro di arrivare puntuale, dovrei partire un’ora prima. Questo è il costo economico del non sapere: senza dati, siamo costretti a un sovraccarico di precauzioni costante. Trattiamo ogni banale spostamento come se fosse un potenziale cigno nero, un evento catastrofico.

Costruire l’antifragilità: sopravvivere al caos per disaccoppiamento

Quando il sistema ferroviario ha fallito e le mie metriche sono saltate, ho cercato una via d’uscita. Ma ho scoperto che le soluzioni standard erano fragili quanto il treno stesso:

  • Taxi e Bus (sistemi dipendenti): erano entrambi paralizzati dal traffico urbano. Se la strada è bloccata, il taxi e l’autobus condividono lo stesso destino. In termini sistemici, le loro probabilità di fallimento sono correlate.
  • Andare a piedi (sistema antifragile/robusto): alla fine, ho scelto di camminare, anche se era la soluzione più lenta.

Camminare è una soluzione vincente perché è disaccoppiata dall’infrastruttura complessa. Non dipende dai segnali ferroviari, dai motori elettrici o dal traffico stradale. Mentre il taxi restava bloccato, la mia progressione costante a piedi non degradava con il fallimento del sistema circostante. In un mondo in cui non puoi misurare con precisione il Lead Time degli altri, l’unica strategia razionale è avere opzioni che non dipendano dalle fragilità altrui.

Conclusione: il costo del non sapere

Le metriche non servono solo a “misurare quanto siamo bravi”. Servono a definire la natura del mondo in cui stiamo operando. Se i tuoi dati sono obsoleti, non hai più una bussola: ogni fluttuazione statistica si trasforma in un evento da Extremistan che può travolgere la tua operatività.

Il costo di non avere metriche aggiornate è il tempo perso in cautele eccessive, o nel rischio di trovarsi a gestire l’imprevisto senza alcuna preparazione.

Vi lascio con una provocazione: siete sicuri che i dati che state usando oggi per guidare il vostro team non siano solo il ricordo di un sistema che non esiste più? Perché senza una metrica, ogni imprevisto è un caso di Extremistan.

Anticipare o differire? Come leggere il proprio flusso per decidere al momento giusto

Nel management operativo si confrontano costantemente due impulsi opposti: agire subito per non farsi trovare impreparati, oppure aspettare per decidere con più informazioni. Entrambi gli impulsi sono razionali. Entrambi possono essere sbagliati.

Il metodo Kanban non sceglie dogmaticamente tra i due. In articoli precedenti abbiamo esplorato la logica del differimento – perché posticipare le decisioni è un vantaggio competitivo, come calcolare il Last Responsible Moment – e la logica dell’anticipazione – come la Teoria dei Vincoli protegge il collo di bottiglia, perché i buffer condivisi del Critical Chain reggono meglio dei margini individuali.

La domanda che questi articoli lasciano aperta è: come si sceglie tra le due strategie? La risposta non è di gusto, né di filosofia manageriale. È statistica. Dipende da come si comporta il flusso di lavoro della propria organizzazione e dalle caratteristiche del contesto in cui ci si trova ad operare.

Due logiche, entrambe valide, in contesti diversi

La Teoria dei Vincoli dice: identifica il collo di bottiglia, ottimizza il suo carico di lavoro, proteggilo con un buffer immediatamente a monte, sincronizza tutto il resto al suo ritmo. Come abbiamo visto nell’articolo sul Drum-Buffer-Rope, questa logica funziona bene quando il collo di bottiglia è stabile e identificabile.

Lean e Kanban dicono invece: non impegnarti finché non devi, tieni aperte le opzioni, usa il Last Responsible Moment come punto limite di impegno. Il differimento riduce il lavoro abortito, migliora la qualità delle decisioni, libera capacità per le urgenze reali.

Il Critical Chain Project Management – che abbiamo esplorato di recente – trova una sintesi parziale: elimina i buffer individuali (fonte di spreco) e li aggrega in buffer condivisi di progetto, che vengono però allocati in anticipo. È anticipazione al servizio del sistema, non del singolo elemento di lavoro.

Queste logiche non si contraddicono: operano bene in domini diversi. Il problema è che molte organizzazioni applicano l’una o l’altra per abitudine, senza chiedersi quale sia appropriata al loro contesto specifico.

Il criterio: leggere la distribuzione del Lead Time

Nell’articolo sulla gestione proattiva dei rischi abbiamo introdotto la distinzione di Nassim Taleb tra Mediocristan ed Extremistan come modello di riferimento per classificare il rischio organizzativo. Quella distinzione diventa qui uno strumento operativo per la scelta strategica tra anticipazione e differimento.

Mediocristan è il dominio in cui le distribuzioni sono gaussiane o super-esponenziali (thin-tail): la media è significativa, la variabilità è contenuta entro limiti prevedibili, gli eventi estremi sono rari e di impatto limitato. Tecnicamente, il rapporto tra il valore di coda e la mediana è inferiore a 5.6. In questo dominio la Legge di Little funziona come strumento previsionale affidabile – a patto di avere almeno 70-100 punti dati per validare il tipo di distribuzione.

In Mediocristan l’anticipazione è una copertura legittima del rischio. I buffer della Teoria dei Vincoli hanno senso, la Critical Chain funziona, le scadenze fisse sono gestibili perché la distribuzione dei tempi di completamento è prevedibile. Impegnarsi in anticipo non è una scommessa: è una protezione calcolata.

Extremistan è il dominio delle distribuzioni a coda lunga (fat-tail), dove la variabilità non è contenuta e gli eventi estremi sono frequenti e di impatto sproporzionato. Il rapporto coda/mediana supera 5.6: un singolo elemento di lavoro può durare 10 o 100 volte la mediana, e la media non rappresenta nulla di utile.

In Extremistan anticipare è pericoloso. Chi pianifica su una media che non rappresenta la distribuzione reale si espone sistematicamente ai cosiddetti Cigni Neri: eventi nella coda lunga che distruggono le previsioni e con esse la fiducia del cliente. La strategia corretta è il differimento estremo: mantenere l’opzionalità il più a lungo possibile, impegnarsi solo quando l’incertezza si è sufficientemente ridotta.

Lo strumento diagnostico è già a disposizione di qualsiasi organizzazione che misuri i propri Lead Time: l’istogramma della distribuzione. Una distribuzione con una coda lunga e asimmetrica verso destra – magari con un picco visibile tra il corpo principale e pochi valori anomali molto distanti – è il segnale che si opera in Extremistan. Una distribuzione più compatta e simmetrica indica Mediocristan. Prima di scegliere la strategia, bisogna guardare la forma della curva e il rapporto coda/mediana.

Il principale motore che spinge un flusso verso Extremistan sono le dipendenze esterne: fornitori, approvazioni regolamentari, decisioni di terze parti. Una singola dipendenza esterna non governata può allungare la coda in modo molto significativo. In questi casi i sistemi di prenotazione (Reservation Systems) sono lo strumento per mitigare il rischio di coda senza rinunciare all’opzionalità.

Le implicazioni per le Classi di Servizio

La distinzione Mediocristan/Extremistan non è solo teorica: cambia concretamente il significato del triage e le sue politiche per ciascuna classe di servizio.

Le classi Expedite e Fixed Date funzionano nel Mediocristan, dove la scadenza ha un fondamento statistico. La data fissa è gestibile perché la distribuzione dei tempi di completamento è prevedibile; la classe Expedite indica un’urgenza reale perché il costo del ritardo cresce in modo identificabile. In Extremistan, una Fixed Date è spesso una scommessa: si fissa una data attesa senza sapere se la distribuzione dei tempi di completamento permetterà di rispettarla. Tra una data attesa e una data prevista c’è una grande differenza. L’urgenza Expedite rischia di diventare la norma, non l’eccezione.

La classe Standard segue il Last Responsible Moment in entrambi i domini, ma con una differenza critica: il calcolo del 50° percentile è significativo solo in Mediocristan, dove la mediana è stabile e rappresentativa. In Extremistan la mediana stessa può essere instabile con campioni ridotti.

La classe Intangible diventa il rifugio naturale per gli elementi di lavoro in Extremistan: si entra nel flusso solo quando l’incertezza è scesa a un livello gestibile, trattando il lavoro come opzione reale fino a quel momento. È la classe che meglio preserva l’opzionalità in condizioni di alta variabilità.

La maturità organizzativa come percorso verso la scelta consapevole

Il Kanban Maturity Model (KMM) descrive un percorso di evoluzione organizzativa che è anche, in questo contesto, un percorso verso la capacità di scegliere consapevolmente tra anticipazione e differimento.

Nelle organizzazioni che si affacciano per la prima volta alla gestione del flusso, la misurazione sistematica del Lead Time è assente o sporadica. Non si ha nemmeno l’istogramma per capire in quale dominio si opera. La scelta tra anticipazione e differimento è inconsapevole: si anticipa per ansia, si differisce per inerzia, senza un criterio. L’urgenza Expedite è endemica perché nessuno ha mai separato le urgenze vere dalle urgenze percepite.

Man mano che l’organizzazione matura – introducendo limiti al lavoro in corso, misurando i Lead Time, stabilizzando il flusso – emerge la capacità di leggere la distribuzione. A quel punto la scelta diventa informata: si può identificare se si opera in Mediocristan o Extremistan, applicare la politica di triage appropriata, calcolare il Last Responsible Moment con basi statistiche solide.

Le organizzazioni più mature compiono un passo ulteriore: lavorano attivamente per spostare il proprio flusso verso Mediocristan attraverso il trimming della coda – l’eliminazione sistematica dei valori anomali che allungano la distribuzione. La resilienza non si costruisce accettando la coda lunga come un dato di fatto: si costruisce attrezzando il sistema per identificarla e ridurla. A quel livello, l’anticipazione diventa possibile su basi sempre più ampie.

Il Two-Phase Commit come sintesi pratica

Come convivere con entrambe le logiche in un sistema reale? La risposta operativa è la separazione dell’impegno in due fasi distinte – un concetto introdotto nell’articolo sul Last Responsible Moment e che trova qui la sua collocazione strategica più ampia.

La prima fase – l’impegno a fare il lavoro – è possibile in entrambi i domini. L’organizzazione accetta la richiesta e la inserisce nel flusso, garantendo al cliente che il lavoro verrà fatto. Questo impegno non dipende dalla prevedibilità della distribuzione.

La seconda fase – l’impegno su una data di consegna specifica – è affidabile solo in Mediocristan, o quando un elemento di lavoro in Extremistan ha percorso abbastanza strada all’interno del flusso da uscire dalla coda lunga e diventare più prevedibile. Dare una data prima di questo punto non è trasparenza verso il cliente: è una scommessa che si scarica sul cliente stesso quando la previsione fallisce.

Questa separazione è la risposta concreta alla domanda di apertura. Non si tratta di scegliere una volta per tutte tra anticipazione e differimento: si tratta di applicare la logica giusta al momento giusto, su basi statistiche, con la consapevolezza di quale dominio si sta attraversando.

Gestire l’incertezza nei progetti: come il Critical Chain Project Management supporta il metodo Kanban

Chi lavora con il metodo Kanban impara presto a gestire il flusso: visualizza il lavoro, limita il WIP, misura il lead time. Quando il lavoro si fa più complesso – progetti con scadenze fisse, risorse condivise tra più attività e dipendenze articolate – è utile affiancare anche il Critical Chain Project Management (CCPM).

Sviluppato da Eliyahu M. Goldratt, il padre della Teoria dei Vincoli, il CCPM parte da una domanda scomoda: perché, nonostante pianificazioni meticolose e stime prudenti, i progetti finiscono quasi sempre in ritardo? La risposta di Goldratt ribalta alcune delle convinzioni più radicate su come gestiamo il tempo e le risorse – e per chi lavora con Kanban, più di un punto risulterà familiare.

La vera causa dei ritardi: non le attività, ma le risorse

La gestione dei progetti tradizionale, basata sul Metodo del Percorso Critico (CPM), si concentra esclusivamente sulla sequenza di attività più lunga per determinare la durata del progetto. L’innovazione fondamentale del CCPM è identificare, invece, la Catena Critica: la sequenza più lunga che considera sia le dipendenze tra i compiti sia le limitazioni delle risorse.

Questo è un cambio di prospettiva radicale. Il vero collo di bottiglia che determina la durata di un progetto non è quasi mai la lista delle cose da fare, ma una persona, un team o un’attrezzatura specifica condivisa tra più attività.

Per capire la differenza, immaginiamo un progetto semplice. Due attività possono partire in parallelo dopo una fase iniziale comune, ma richiedono entrambe la stessa risorsa critica: l’ingegnere capo. Il Metodo del Percorso Critico non vedrebbe problemi, ma il CCPM riconosce subito che le due attività non possono avvenire contemporaneamente. La vera sequenza più lunga – la Catena Critica – deve quindi includere la scelta di quale attività fare prima, rivelando un vincolo che altrimenti resterebbe invisibile fino al momento dell’esecuzione.

L’illusione della sicurezza: come i margini individuali rallentano tutto

L’idea controintuitiva più potente del CCPM riguarda i margini di sicurezza. Tradizionalmente, ogni membro del team aggiunge un margine di tempo alla stima di ogni singola attività per proteggersi dagli imprevisti. Fred, uno dei personaggi del romanzo Critical Chain di Goldratt, porta dati reali della sua azienda: quasi metà delle attività finisce esattamente alla scadenza, pochissime finiscono prima, e circa un terzo finisce con un 10-20% di ritardo rispetto alla stima originale. La sua conclusione è che il margine di sicurezza individuale non protegge né il singolo step né il progetto nel suo insieme.

Questa tolleranza incoraggia comportamenti controproducenti. La sindrome dello studente – termine coniato da Goldratt – descrive il meccanismo per cui, avendo tempo a disposizione, si procrastina fino all’ultimo: quando si inizia a lavorare, il cuscinetto è già stato consumato, e l’attività finisce comunque in ritardo. A questo si aggiunge la Legge di Parkinson: il lavoro si espande fino a occupare tutto il tempo disponibile.

Il CCPM elimina questi margini individuali nascosti. Le stime delle attività diventano più aggressive, basate sul tempo effettivamente necessario per completarle. La sicurezza rimossa viene aggregata e resa esplicita in “buffer” condivisi che proteggono l’intero progetto:

  • Project Buffer: posto alla fine della catena critica per proteggere la data di consegna finale dall’incertezza accumulata.
  • Feeding Buffer: inseriti dove le catene di attività secondarie si collegano alla catena critica, per evitare che i ritardi su percorsi non critici impattino su quello principale.
  • Resource Buffer: utilizzati per garantire che le risorse critiche siano pronte e disponibili esattamente nel momento in cui sono necessarie.

Questo approccio trasforma l’incertezza da un problema individuale a una responsabilità collettiva.

La figura mostra un esempio di rete CCPM. La catena critica – in giallo – segue il percorso A→C→E→F→H. Due percorsi non critici convergono su di essa: il primo attraverso B e D, che si aggancia in H tramite feeding buffer; il secondo attraverso G e I, che si aggancia in F tramite feeding buffer. Il project buffer finale protegge la data di consegna dall’incertezza accumulata sull’intero progetto.

La psicologia del progetto efficace: il project multitasking come causa sistemica dei ritardi

Il CCPM scoraggia attivamente il multitasking, e non si riferisce solo all’abitudine individuale di saltare da un compito all’altro. La forma più dannosa è quella organizzativa: aprire troppi progetti in contemporanea. È una dinamica comune – ogni progetto sembra urgente al momento dell’approvazione, il portfolio cresce, le stesse risorse critiche vengono distribuite su tutto. Il risultato è che nessun progetto avanza davvero, perché ogni risorsa chiave è costantemente interrotta, richiamata, riassegnata.

Goldratt dimostra questo con un esempio quantitativo: una persona che lavora in multitasking su tre attività da dieci giorni ciascuna, alternandosi ogni cinque giorni, vede il Lead Time di ognuna raddoppiare – e questo senza considerare il tempo perso nei cambi di contesto. Il meccanismo diventa poi sistemico: più progetti aperti allungano i Lead Time, Lead Time più lunghi significano più progetti in corso contemporaneamente, e il ciclo si autoalimenta. Goldratt lo definisce esplicitamente “il principale killer del Lead Time”.

La soluzione proposta è controintuitiva: aprire meno progetti contemporaneamente. Non per fare meno, ma per finire di più – perché le risorse critiche possono finalmente completare un lavoro prima di passare al successivo. Chi conosce il metodo Kanban riconoscerà qui la logica dei WIP limit: ridurre il lavoro in corso non è una limitazione, ma la condizione che rende stabile il flusso.

La figura mostra l’effetto in modo immediato: lavorare sulle attività di tre progetti in parallelo raddoppia il lead time di ciascuno. Lo stesso principio del WIP limit si applica sia alle singole attività, che ai progetti presenti nel portfolio.

Un nuovo modo di misurare: non le scadenze, ma il consumo del buffer

Nel project management tradizionale, la domanda chiave è: “Siamo in linea con la tabella di marcia?”. Nel CCPM diventa: “Quanta parte del nostro buffer abbiamo consumato rispetto ai progressi fatti?”.

Per rispondere, il CCPM introduce il Fever Chart (“grafico della febbre”): un grafico che mette in relazione la percentuale di completamento della catena critica con la percentuale di buffer consumato. Le tre zone (verde, gialla e rossa) funzionano come un termometro. La sua forza è predittiva: trovarsi nella zona gialla non significa che il progetto è in ritardo, ma che il rischio di un futuro ritardo è aumentato. Un approccio familiare a chi usa le metriche di flusso del Kanban, come i CFD: anche lì l’obiettivo è anticipare i problemi, non certificare i ritardi.

Il Fever Chart mette in relazione l’avanzamento del progetto con il consumo del project buffer. La curva bianca mostra l’andamento reale: nel nostro esempio il progetto entra in zona rossa nella prima metà, per poi rientrare in zona gialla verso la fine – uno strumento predittivo che non certifica i ritardi, ma li anticipa in tempo utile per intervenire.

Risultati concreti: cosa dicono i casi reali

Il CCPM non è un esperimento accademico. La NASA lo ha utilizzato per gestire le gallerie del vento al Langley Research Center, riuscendo a mantenere il volume di test nonostante un taglio del 50% del personale. Procter & Gamble Pharmaceuticals lo ha adottato nel 2004 per gestire un aumento del carico di lavoro senza risorse aggiuntive, riducendo i tempi di ciclo nei trial clinici. In letteratura le riduzioni documentate delle durate di progetto vanno dal 20% al 40% rispetto ai metodi tradizionali.

Conclusione

Il CCPM è molto più di una tecnica di pianificazione: è una filosofia manageriale che rende l’incertezza visibile, misurabile e gestibile. La vera sfida non è tecnica ma culturale: rinunciare alla protezione individuale per contribuire a una riserva comune. È un cambio di mentalità che richiede fiducia nel sistema – e nella capacità collettiva di tenere insieme ciò che il lavoro individuale tende a frammentare.

Bibliografia

  1. Eliyahu M. Goldratt, Critical Chain, Gower Publishing, 1997.
  2. Andrew G. Hagemann, Use of the Critical Chain Project Management Technique at NASA Langley Research Center, 20th Digital Avionics Systems Conference (DASC), IEEE, 2001.
  3. Michelle Smith, CCPM: A Sustaining Strategy at Procter & Gamble Pharmaceuticals, Pharmaceutical Processing World, 2004.

L’arte del timing strategico: l’importanza del Last Responsible Moment (LRM) nell’impresa resiliente

Nel panorama della gestione organizzativa moderna, l’ossessione per la velocità ha spesso oscurato la qualità del processo decisionale. Tuttavia, nel quadro del Kanban Maturity Model (KMM), la vera agilità non risiede nel decidere il più velocemente possibile, ma nel decidere al momento giusto. Il concetto di Last Responsible Moment (LRM) emerge non come una forma di procrastinazione, ma come una scelta strategica di gestione del rischio economico.

In un contesto caratterizzato da incertezza e complessità, decidere troppo presto è un errore pari a quello di decidere troppo tardi: impegna risorse preziose su basi informative incomplete, precludendo la possibilità di adattarsi a nuovi dati. L’LRM invece rappresenta il punto immediatamente precedente alla perdita di fattibilità di un’opzione. Comprendere l’LRM è il primo passo per evolvere da una cultura dell’urgenza reattiva a una gestione proattiva del flusso, dove il tempo è una variabile economica controllata e non un nemico da rincorrere.

La logica del differimento: perché “aspettare” è un vantaggio competitivo

Il differimento dell’impegno (deferred commitment) è una delle pratiche più controintuitive dell’enterprise agility. Permettere a un elemento di lavoro di rimanere nello stato di opzione il più a lungo possibile riduce drasticamente l’impatto della failure demand, ovvero il lavoro abortito e i rifacimenti (rework). Da un punto di vista del senior management, differire l’impegno significa mantenere maggiore liquidità del sistema – capacità produttiva non ancora congelata in scommesse premature, e quindi disponibile per essere allocata quando le informazioni sono più complete.

I tre benefici strategici del differimento dell’impegno sono:

  • Acquisizione di conoscenza: più a lungo si attende, più informazioni si raccolgono su mercato, tecnologie ed esigenze reali dei clienti.
  • Riduzione dell’incertezza: il tempo permette di dissipare l’incertezza decisionale, trasformando intuizioni rischiose in decisioni basate su evidenze.
  • Aumento del tasso di scarto delle opzioni non valide: un sistema che differisce l’impegno seleziona solo le opzioni che sopravvivono all’evoluzione del contesto, eliminando lo spreco alla radice.
Fonte Kanban University – dettaglio del poster Triage Tables

Anatomia matematica del Last Responsible Moment e del rischio temporale

L’LRM non è un’intuizione soggettiva, ma un calcolo basato sulla distribuzione statistica dei tempi di completamento (Lead Time). In un sistema evoluto, la determinazione del momento in cui iniziare un lavoro dipende dalla data di consegna desiderata (Desired Delivery Date – DDD) e dalla probabilità di completamento entro quella data.

Operativamente, l’LRM è definito come il 50° percentile del Lead Time calcolato a ritroso rispetto alla DDD. Iniziare un lavoro esattamente al LRM significa che, in base alla distribuzione storica dei tempi di consegna (Lead Time), c’è solo una possibilità su due (50%) di consegnare entro la data desiderata (DDD). Per le organizzazioni a ML2/ML3, questo rappresenta il punto di equilibrio tra rischio di consegna tardiva e costo del ritardo.

ConcettoDefinizione operativaImplicazione economica
Last Responsible MomentDecisione consapevole basata sul 50° percentile della distribuzione del Lead Time.Rischio gestito: equilibrio tra informazione acquisita, Cost of Delay e probabilità di consegna puntuale.
Irresponsibly LateDecisione presa oltre la finestra di confidenza statistica.Scommessa probabilistica: l’organizzazione subisce le conseguenze di un eventuale fallimento invece di gestire il rischio.

Un pilastro tecnico fondamentale è l’Urgenza, definita come la derivata (pendenza) della funzione Probable Cost of Delay in Starting (PCoDS). Senza entrare in tecnicismi matematici, la PCoDS è una curva che indica il rischio economico immediato derivante dal non iniziare un lavoro in una data specifica.

Il Last Responsible Moment e la disciplina del triage: ora, dopo, mai

L’integrazione dell’LRM trasforma il Replenishment Meeting in un processo di triage rigoroso. Basandoci sulla valutazione delle opzioni reali, comprendiamo che queste hanno valore e hanno una scadenza; pertanto, non si deve mai decidere in anticipo senza un motivo esplicito.

Il triage categorizza il lavoro in tre direzioni:

  1. Ora: elementi che hanno raggiunto il proprio LRM e devono essere messi in lavorazione per onorare la promessa di consegna.
  2. Dopo: opzioni che non hanno ancora raggiunto l’LRM e restano in attesa perché si possa acquisire ulteriore conoscenza relativa alla loro lavorazione.
  3. Mai: opzioni scartate perché superate da nuove informazioni.

Questa logica di triage è applicabile esclusivamente a opzioni per le quali i dati storici sono significativi. Se il valore dell’opzione è incerto o imprevedibile l’LRM perde di efficacia e l’elemento deve essere gestito tramite allocazione di capacità dedicata come classe Intangible.

Il compromesso strategico: Classi di Servizio e Costo del Ritardo

Differire l’impegno fino all’LRM comporta un trade-off. Se si attende troppo vicino al limite, il sistema viene caricato di rischi temporali che possono richiedere classi di servizio costose per garantire la consegna.

Le quattro classi di servizio canoniche riflettono la sensibilità al tempo e alla PCoDS:

  1. Expedite: per elementi con urgenza critica e pendenza della PCoDS altissima. Richiedono un intervento immediato, spesso violando i limiti al lavoro in corso (WIP).
  2. Fixed Date: elementi con data di consegna fissa e costo elevato per il superamento della scadenza. Richiedono impegno vicino all’LRM con priorità di pianificazione alta.
  3. Standard: il cuore del sistema, gestito solitamente tramite logica FIFO (First-In, First-Out) per garantire massima prevedibilità e stabilità del Lead Time.
  4. Intangible: elementi con basso costo del ritardo immediato ma alto valore a lungo termine. Fungono da protezione rispetto al rischio strategico: la loro presenza nel sistema crea lo spazio necessario per assorbire le richieste Expedite senza destabilizzare il flusso.

Evoluzione organizzativa: dal caos alla resilienza

La padronanza dell’LRM evolve man mano che le organizzazioni si strutturano:

  • ML2 (Customer Awareness): le decisioni sono spesso emotive o reattive. Il Flow Manager inizia a raccogliere dati, ma la mancanza di stabilità rende il calcolo dell’LRM ancora approssimativo.
  • ML3 (Fit-for-Purpose): emergono i ruoli chiave. Il Service Request Manager (SRM) diventa il custode delle opzioni e dell’LRM, mentre il Service Delivery Manager (SDM) garantisce la stabilità della capacità del sistema. Il triage diventa sistematico.
  • ML4 (Risk-Hedged): l’LRM non è più una stima generale al 50° percentile, ma un calcolo specifico per ogni elemento di lavoro ad alto valore, basato su simulazioni Monte Carlo e profili PCoDS personalizzati.

Conclusione: il Last Responsible Moment come pilastro della prosperità aziendale

Il Last Responsible Moment non è un tecnicismo, ma il fondamento della resilienza strategica. La sua applicazione sposta l’attenzione dalla mera efficienza delle risorse (tenere le persone occupate) alla efficienza di flusso e alla resilienza economica.

Il traguardo finale di questa disciplina è l’allineamento tra identità aziendale, strategia (perché/cosa) e decisioni operative quotidiane (come/chi). Quando un’organizzazione sa perché decide e quando è il momento di farlo, smette di subire il mercato e inizia a guidarlo.

La leadership dell’organizzazione deve investire nella raccolta rigorosa dei dati sui Lead Time e nella modellizzazione dei costi del ritardo. Solo trasformando l’LRM da concetto astratto a strumento guidato dai dati, l’organizzazione potrà prosperare a lungo termine in un mondo volatile.

Metriche di flusso: cosa misuriamo davvero quando misuriamo la produttività?

In molte organizzazioni, quando si parla di produttività degli uffici, si parte da un’intuizione apparentemente ragionevole: se le persone sono occupate, il lavoro avanza. Se le ore registrate aumentano, la produttività aumenta. Peccato che questa logica, portata alla prova dei dati, si riveli quasi sempre sbagliata.

Il problema dell’effort

Misurare le ore di lavoro – l’effort – dice quanto tempo le persone hanno dedicato a qualcosa. Non dice quanto lavoro è stato effettivamente completato. Sono due cose diverse, e confonderle genera decisioni sbagliate.

Un ufficio che gestisce pratiche amministrative può essere pieno di persone impegnate tutto il giorno, eppure produrre meno output di un ufficio più snello e meno saturo. Il motivo è semplice: quando le persone sono troppo occupate, il sistema si inceppa alla minima perturbazione – una richiesta urgente, un’assenza, una dipendenza esterna. Il lavoro si accumula, i tempi si allungano, e nessuno capisce esattamente perché.

La misura che conta, invece, è il Throughput: quante pratiche vengono effettivamente completate in un dato periodo. Registrazioni, contratti, acquisti, variazioni – qualsiasi cosa rappresenti un’unità di lavoro conclusa. Se il Throughput aumenta a parità di organico, la produttività sta crescendo. Non ci sono interpretazioni: è un dato empirico, diretto, semplice da raccogliere.

Livelli di servizio: sapere non basta, bisogna collegare

Una volta che si inizia a misurare il Throughput, emerge naturalmente una seconda domanda: in quanto tempo completiamo le pratiche? È qui che entrano in gioco i Service Level Agreement (SLA), ovvero gli impegni misurabili che un ufficio può comunicare ai propri interlocutori interni ed esterni.

Un esempio concreto: l’ottantacinquesimo percentile dei Lead Time è di 15 giorni. Che in termini semplici significa: l’85% delle richieste di un determinato servizio viene gestito entro 15 giorni. È un dato reale, ricavato dai sistemi in uso, ma da solo non dice ancora nulla di utile. La domanda che conta non è “è tanto o è poco?”, ma: qual è l’impatto reale sull’organizzazione se questi tempi restano invariati, si allungano, o si accorciano?

Senza questa misura di impatto, qualsiasi target è arbitrario. Fissare un obiettivo di 8 giorni invece di 15 potrebbe essere un miglioramento significativo o uno spreco di risorse, dipende da cosa succede a valle. Finché non colleghiamo le metriche operative alle conseguenze organizzative, stiamo ottimizzando nel vuoto.

Questo è il nodo: spesso non è che manchino i dati. Manca il collegamento tra i dati e le decisioni.

Gestire i picchi con i dati storici

Molte organizzazioni di servizio, e anche molti uffici amministrativi, vivono di stagionalità: certi periodi dell’anno concentrano volumi di lavoro molto superiori alla media. Pensate per esempio un ufficio paghe: avrà dei picchi di lavoro da evadere in corrispondenza di ogni fine mese.

Il modo tradizionale di gestire questi picchi è reattivo: si aspetta che il sistema si inceppi, poi si aggiunge personale o si fanno straordinari. Il modo alternativo è usare i dati storici per anticipare i picchi e attivare risorse aggiuntive – interne o esterne – solo quando e dove servono davvero. Una capacità extra controllata invece di un’emergenza ricorrente.

Capacity planning: vedere la coperta prima che sia troppo corta

Quando un ufficio gestisce attività diverse, la sfida non è solo fare di più, ma bilanciare. La coperta è sempre potenzialmente corta, e senza una mappa dell’allocazione reale delle risorse è impossibile sapere dove concentrare l’attenzione.

La settimana tipo è uno strumento semplice: si mappa come viene effettivamente distribuito il tempo del team tra le diverse categorie di attività, e si confronta questa distribuzione con i volumi di lavoro in arrivo. Questo confronto rende visibili i colli di bottiglia prima che diventino crisi, e permette di spostare risorse in modo consapevole invece di rincorrere le urgenze.

Ho diffusamente parlato di questa pratica in un’articolo al quale rimando per gli approfondimenti.

Il lavoro sommerso

C’è un ultimo problema, forse il più sottovalutato: il lavoro invisibile. In ogni ufficio esiste una quota significativa di attività che non viene tracciata – richieste gestite via email, richieste urgenti, eccezioni, supporto informale. Questo lavoro sommerso consuma capacità reale, ma non appare in nessuna metrica. Risultato: le analisi partono da dati incompleti, e le decisioni che ne derivano sono distorte.

La soluzione non è burocratizzare ogni attività, ma rendere visibile almeno la massa del lavoro sommerso – anche in modo aggregato – per avere una visione sistemica e bilanciata della situazione.

Le cadenze: dove avviene il vero miglioramento

Tutto questo – throughput, SLA, capacity planning, visibilità sul lavoro sommerso – è necessario ma non sufficiente. Le metriche contano solo se vengono usate con regolarità per fare domande precise: cosa sta cambiando? Cosa proviamo a migliorare? Come misuriamo se l’intervento ha funzionato?

Questo è il principio del miglioramento continuo: non un progetto straordinario, ma un meccanismo ordinario. Si fissa una cadenza di revisione – settimanale, bisettimanale, mensile – si guardano i dati, si formula un’ipotesi di miglioramento, si prova, si misura l’effetto. Se funziona, si consolida nel metodo. Se non funziona, si cambia strada.

È un metodo forse noioso da farsi, ma sorprendentemente foriero di risultati nel tempo.

In sintesi

Cosa misurarePerché
ThroughputMisura il lavoro realmente completato, non l’occupazione di tempo
Lead time / SLAPermette di prendere impegni misurabili con gli interlocutori interni ed esterni
Distribuzione per attivitàRende visibili i colli di bottiglia e bilancia i carichi
Volume storicoPermette di anticipare i picchi invece di subirli
Cadenze di revisioneTrasforma i dati in decisioni e iniziative di miglioramento continuo

Nessuno di questi strumenti richiede tecnologie complesse. Richiedono disciplina, continuità, e la disponibilità a prendere decisioni basate sui dati invece che sulle sensazioni. Il metodo Kanban offre esattamente questo: un sistema di pratiche, cadenze e metriche progettato per rendere tutto ciò ordinario – non un progetto straordinario, ma il modo normale di lavorare.

Un’ultima cosa: non è una questione di settore

C’è una storia che vale la pena raccontare, perché smonta un alibi molto comune.

Toyota è oggi il produttore di auto più grande al mondo. Produce 2 milioni di auto in più rispetto a Volkswagen (11 milioni circa contro 9 milioni circa), con circa la metà del personale. Non è successo perché fanno auto, perché sono giapponesi, o perché hanno avuto accesso a tecnologie particolari. È successo perché hanno applicato per più di settant’anni con rigore e continuità il metodo scientifico ai propri processi: osservare, misurare, formulare un’ipotesi, sperimentare, misurare di nuovo. Consolidare ciò che funziona, abbandonare ciò che non funziona. Ricominciare.

Chi dice “da noi non funzionerebbe, il nostro settore è diverso” di solito non sta descrivendo una realtà, sta descrivendo una resistenza. Il metodo scientifico non conosce settori. Funziona dove si è disposti a guardare i dati e a cambiare idea quando i dati lo chiedono.

Un ufficio amministrativo o una organizzazione di servizi non è una fabbrica di automobili. Ma le domande sono le stesse: quanto lavoro stiamo completando? In quanto tempo? Dove si accumula? Cosa succede se cambiamo qualcosa? La differenza tra chi migliora e chi resta fermo non è mai nella complessità degli strumenti, è nella disponibilità a fare quelle domande ogni settimana, senza mai smettere.

Perché vediamo solo quello che facciamo noi

C’è un esperimento mentale che mi piace proporre durante i workshop. Immagina due persone che dividono un compito al cinquanta per cento. Per metà del tempo lavorano insieme, visibili l’una all’altra. Per l’altra metà, ciascuna lavora per conto proprio, fuori dalla vista dell’altra. Dopo qualche ora, chiedi a entrambe quanto pensano di aver contribuito.

La risposta, quasi invariabilmente, è di avere lavorato il doppio dell’altra persona.

Due terzi ciascuna. Il cento per cento sommato fa centotrenta. Qualcosa non torna, eppure entrambe sono convinte della propria stima.

Non si tratta di malafede. Si tratta di come funziona il nostro cervello.

WYSIATI: quello che vedi è tutto quello che c’è

Daniel Kahneman, nel suo lavoro sulla cognizione e le decisioni umane, ha descritto con precisione il meccanismo alla base di questa distorsione. Lo ha sintetizzato con l’acronimo WYSIATI – What You See Is All There Is: quello che Kahneman chiama il Sistema 1 del nostro cervello, quello veloce e automatico, costruisce la propria narrativa esclusivamente a partire dalle informazioni disponibili, senza rendersi conto di ciò che manca. Non considera i “known unknowns” – le cose che sa di non sapere – e men che meno gli “unknown unknowns” – le cose che non sa di non sapere. Si limita a costruire la storia più coerente possibile con quello che ha davanti, e la tratta come se fosse completa.

Uno dei meccanismi con cui WYSIATI si manifesta concretamente è l’euristica della disponibilità: tendiamo a giudicare la probabilità o l’importanza di qualcosa in base a quanto facilmente riusciamo a richiamarla alla mente. Non in base a dati oggettivi, non in base a frequenze reali, ma in base alla facilità di accesso all’informazione.

Gli incidenti aerei fanno notizia. I voli sicuri no. Risultato: sovrastimiamo drammaticamente la pericolosità dell’aereo rispetto all’automobile, anche quando i numeri dicono l’esatto contrario. I divorzi tra attori e attrici ci sembrano frequentissimi, perché ne sentiamo parlare spesso. I divorzi tra idraulici ci sembrano rari, perché non fanno notizia. Eppure le statistiche reali raccontano una storia molto diversa.

Il problema si manifesta ogni giorno, nei team

Torniamo all’esperimento delle due persone. Perché ciascuna si attribuisce due terzi del lavoro?

Perché il proprio contributo è sempre visibile a sé stessi – si ricorda ogni singola attività svolta, ogni problema risolto, ogni ora investita. Il contributo dell’altro, invece, è parzialmente invisibile: si vede solo la metà del tempo trascorsa insieme. L’altra metà, quella in cui l’altro ha lavorato da solo, è semplicemente assente dalla propria esperienza.

L’euristica della disponibilità fa il resto: ciò che non si vede non viene pesato. Ciò che si vede viene sovrastimato.

Questo non è un problema teorico. È la fonte di una quota enorme di attriti nei team di lavoro. “Faccio tutto io.” “Nessuno si accorge di quanto mi impegno.” “Gli altri non contribuiscono quanto dovrebbero.” Queste frasi non nascono necessariamente da egocentrismo o da conflitto: nascono da una distorsione cognitiva sistematica, condivisa da tutti i membri del team, ciascuno convinto, in buona fede, di fare di più degli altri.

Lo stesso meccanismo si ripete nelle relazioni personali, nei progetti interfunzionali, nelle collaborazioni tra reparti. Ogni volta che una parte del lavoro è invisibile, la percezione si distorce.

La soluzione non è solo lavorare di più sulla cultura

La risposta istintiva a questi problemi è spesso di tipo culturale: migliorare la comunicazione, costruire fiducia, lavorare sull’empatia. Tutte cose valide, ma non sufficienti se si ignorano le radici cognitive del problema.

Se il problema è che il cervello non elabora ciò che non vede, la soluzione non può essere solo culturale. Deve essere strutturale: rendere visibile ciò che altrimenti non lo è.

Visualizzare il lavoro non è un esercizio estetico. Non è una questione di bacheche colorate o di post-it ordinati. È un atto cognitivo: portare nel campo percettivo di tutti le informazioni che altrimenti resterebbero inaccessibili e quindi, secondo WYSIATI, inesistenti.

Una Kanban board, nella sua forma più semplice come nella sua versione più sofisticata, fa esattamente questo: rende esplicito chi fa cosa, in quale stato si trova ogni attività, e – se ben configurata – quanto lavoro è in corso contemporaneamente. Quando il flusso è visibile per tutti, le distorsioni della disponibilità si riducono. Non si discute più di percezioni, si discute di fatti condivisi.

Misurare chiude il cerchio

La visualizzazione, da sola, non basta. Perché anche una board ben costruita mostra solo uno snapshot: il presente, o al massimo il recente passato. Per ragionare su tendenze, capacità, colli di bottiglia, distribuzione reale del carico, serve misurare.

La misurazione trasforma le osservazioni qualitative in dati confrontabili. Strumenti come il Cumulative Flow Diagram mostrano come il lavoro si accumula o scorre nel tempo, rendendo visibili i blocchi sistemici che la percezione quotidiana tende a normalizzare. Metriche come il Lead Time e il Throughput permettono di rispondere a domande che l’intuizione non può risolvere: quanto tempo passa un’attività in attesa? Dove si accumula il lavoro? Chi o cosa è sistematicamente sottovalutato?

Senza misura, anche i team più collaborativi continuano a navigare a vista. E la navigazione a vista, come Kahneman ha dimostrato in decenni di ricerca, favorisce sempre le distorsioni cognitive rispetto alla realtà.

Non si tratta di sorvegliare. Si tratta di vedere.

Vale la pena essere chiari su un punto: visualizzare e misurare non significa sorvegliare le persone. Non significa costruire un sistema di valutazione delle performance individuali basato su metriche. Significa dare a tutti – al team nel suo insieme – una visione condivisa della realtà.

Quando il lavoro è visibile, la conversazione cambia registro. Si passa dal “secondo me” al “secondo i dati”. Si passa dall’attribuzione soggettiva del merito alla comprensione sistemica di come fluisce il lavoro. Si passa, in ultima analisi, dalla difesa della propria percezione alla collaborazione intorno a una percezione comune.

L’euristica della disponibilità non si elimina. È cablata nel nostro modo di pensare, e Kahneman è stato il primo a sperimentare che anche chi conosce le distorsioni cognitive non ne è immune. Ma si può progettare il proprio ambiente di lavoro in modo che le informazioni rilevanti siano sempre disponibili – non solo quelle che capitano sotto gli occhi di chi fa il proprio pezzo di compito nell’angolo della stanza.

Il cervello vede solo quello che ha davanti. Il nostro compito, come team e come organizzazioni, è decidere con cura cosa mettere davanti al cervello.