Come funziona Kanban: dalla stima alla previsione, quando il fornitore sono io

Nell’articolo precedente ho raccontato come prendere le misure a un fornitore lento: misurare io il tempo che passa tra la mia richiesta e la sua risposta, quella che chiamo ‘metrica reciproca’, e regolarmi di conseguenza. Chiudevo con un’osservazione: il livello di servizio che dichiaro a valle deve tenere conto di quello che so del mio fornitore.

Resta però una domanda: quale livello di servizio dichiaro, io? Perché a valle il fornitore sono io. E il mio cliente, che io mi misuri o no, prima o poi la metrica reciproca la prende a me. Esattamente come io l’ho presa al mio fornitore.

Prendere le misure a me stesso

Quando un cliente chiede “per quando?”, di solito si tende a rispondere con una stima. Si guarda il lavoro, si valuta quanto è complicato, si pensa a com’è andata l’ultima volta e si ipotizza una data. È un’opinione, magari esperta, ma resta un’opinione. Una previsione funziona in un altro modo: non guarda il singolo lavoro, guarda come sono andati tutti i lavori simili. Non è un’opinione, è statistica.

Per fare questo lo strumento lo conosciamo già: è la stessa curva di distribuzione del Lead Time che ho costruito per il fornitore, solo che questa volta riguarda la parte del servizio che gestisco io. Con un’avvertenza su cosa misurare, perché è qui che ci si inganna più facilmente.

Il Kanban Maturity Model (KMM) distingue il Customer Lead Time, che parte da quando il cliente fa la richiesta, dal System Lead Time, che parte da quando io la prendo in carico. In mezzo c’è l’attesa all’ingresso: la richiesta è arrivata, ma nessuno ci sta ancora lavorando. Quell’attesa tendo a non vederla, perché per me il lavoro non è ancora cominciato. Il cliente invece la subisce per intero. Se misuro solo il System Lead Time, la mia previsione è strutturalmente ottimistica e il cliente aspetta sistematicamente più di quanto dicano i miei dati.

“I dati non li abbiamo”

Quando ne parlo nelle aziende arriva quasi sempre un’obiezione: “bello, ma i dati non li abbiamo”. In realtà ci sono quasi sempre, solo che non vengono usati. Ogni lavoro chiuso ha lasciato una traccia: una data in cui è stato chiesto e una in cui è stato consegnato, in un sistema di ticketing, in una mail, in un registro, a volte in un foglio Excel che qualcuno compila per abitudine. Non servono strumenti sofisticati per cominciare, serve la disciplina di raccogliere i dati. E, come abbiamo visto nel precedente articolo, se il sistema è stabile una trentina di misurazioni bastano per avere un primo quadro affidabile.

“Ma ogni lavoro è diverso”

La seconda obiezione che ricevo in azienda è più radicata: “il nostro lavoro non si presta, ogni cliente ha esigenze uniche, ogni progetto è un caso a sé”. È vero solo in parte. Il lavoro davvero unico esiste, ma è molto meno di quanto ci piace pensare. Il resto è fatto di attività che ripetiamo ogni settimana, solo che non le tracciamo, e quello che non vediamo ci sembra imprevedibile per definizione.

Di solito il lavoro non è tutto diverso: è di pochi tipi diversi. E i dati, curiosamente, lo mostrano da soli. Il KMM osserva che quando la distribuzione del Lead Time ha più picchi, in genere è perché dentro ci sono più tipi di lavoro mescolati. La risposta, quindi, non è rinunciare a misurare perché “tanto è tutto diverso”, ma separare i dati per tipo e costruire una curva per ciascuno. Tre o quattro tipi di lavoro diventano tre o quattro distribuzioni, e tre o quattro previsioni, ognuna sufficientemente affidabile per il suo tipo.

Dalla distribuzione allo SLE

Dalla distribuzione nasce il livello di servizio che posso dichiarare al cliente, lo SLE (Service Level Expectation): entro quanto tempo consegno, e in quale percentuale di casi. Perché sia una promessa e non un azzardo, però, servono due condizioni.

La prima è che la coda sia sottile, cioè che il rapporto tra il 98° percentile e la mediana stia sotto 5,6. Se la coda è grassa, qualunque numero dichiari è fragile: prima o poi arriva il caso che va lunghissimo e smentisce tutto. In quella situazione il primo lavoro non è promettere, è accorciare la coda statistica.

La seconda è scegliere il percentile giusto. L’85° è il riferimento comune per i servizi, sei volte su sette, ma non è una regola che vale sempre. Dipende da quanto costa al cliente un ritardo: se il ritardo costa molto, conviene salire.
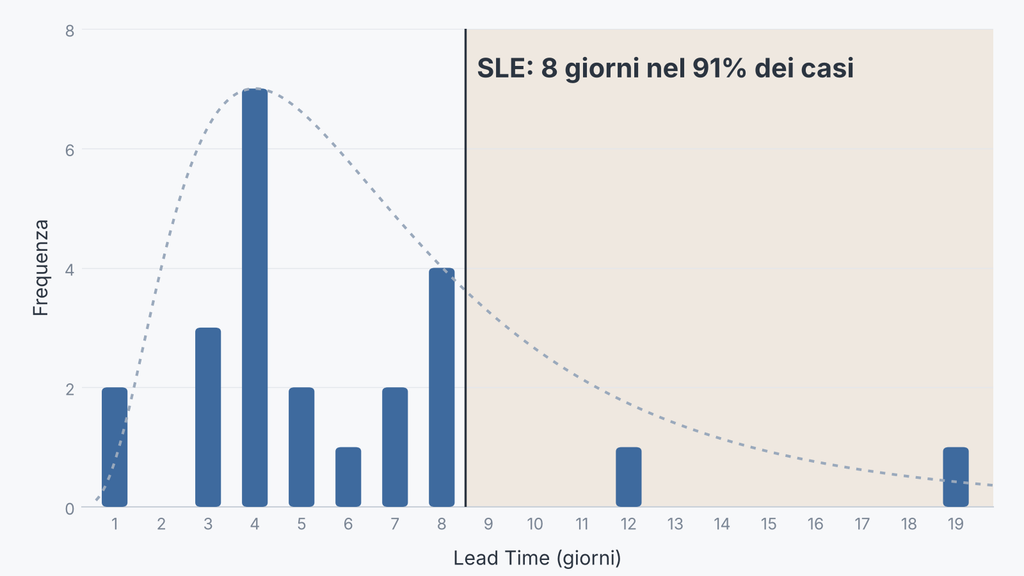
Distribuzione del Lead Time dell’onboarding dopo il primo mese

Un buon esempio di quanto descritto è il caso dell’onboarding di Grow, di cui parlo nell’articolo Migliora le tue risorse umane con Kanban: Kanban in HR – Scaling Kanban in an HR department at Grow (Italy) (case study in inglese). Quando abbiamo cominciato a misurare, il Lead Time andava da 1 a 96 giorni: una coda grassa, su cui nessuna promessa poteva essere affidabile. Non abbiamo dichiarato niente. Siamo intervenuti su uno dei colli di bottiglia, la firma digitale del contratto, e in un mese la coda si è accorciata fino a diventare sottile (19 giorni), con una distribuzione dei tempi di onboarding come nell’immagine. Solo a quel punto abbiamo dichiarato ai reparti richiedenti uno SLE: 8 giorni nel 91% dei casi.

Abbiamo tenuto il percentile più alto dell’85° perché un ritardo nell’onboarding non era un semplice disagio: significava persone al lavoro senza un contratto firmato, con il rischio di sanzioni. Lo stesso servizio, con un costo del ritardo più basso, avrebbe potuto reggersi su un percentile diverso.

Cosa vuole davvero il cliente

Si pensa spesso che il cliente voglia tutto e subito, e che l’unico modo per farlo contento sia promettere tempi brevi. In realtà quello che spesso cerca è un’altra cosa: risposte oneste e previsioni affidabili, con cui fare a sua volta le sue previsioni.

È il meccanismo dell’articolo precedente, visto dall’altra parte del tavolo. Il mio SLE diventa il dato su cui il mio cliente pianifica, esattamente come lo SLE del mio fornitore era il dato su cui pianificavo io. Una data detta con sicurezza, che poi slitta, magari più volte, non gli serve a niente: lo costringe a ripianificare ogni volta. Una previsione affidabile con una probabilità dichiarata invece gli permette di regolarsi. La catena regge solo se ogni anello è onesto e affidabile, e io sono uno degli anelli.

Conclusione

Non è vero, quindi, che non posso promettere niente di affidabile. Come minimo posso misurarmi, con gli stessi strumenti con cui misuro il fornitore, e sapere cosa posso dichiarare. Posso separare i tipi di lavoro invece di nascondermi dietro il “è tutto diverso”, accorciare la coda dove serve prima di promettere, e scegliere il percentile in base a quanto costa davvero un ritardo. E posso dare al mio cliente esattamente quello che io chiedo al mio fornitore: una previsione onesta.

Al giorno d’oggi, poi, c’è una nuova tentazione, più forte che mai: usare l’AI e lasciare che sia lei a fare le previsioni al posto nostro. Ma se il lavoro non è tracciato, l’AI una risposta la dà comunque, sicura e ben presentata, solo che non ha fondamento. È una stima come quella descritta più sopra, ma quando esce da un sistema automatico con un numero e un grafico, smette di sembrare un’opinione e nessuno la mette più in discussione. Decidere cosa misurare e come resta una scelta umana, come ho spiegato nell’articolo Perché collegare l’AI ai vostri dati di flusso non basta.

Quest’ultimo tema è così importante che ho deciso di dedicargli un podcast, che prenderà il via il prossimo mese di novembre. Restate sintonizzati!

Bibliografia

  1. David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention – 2nd Edition, Kanban University Press, 2021
Come funziona Kanban: se il fornitore è lento, non è vero che non posso farci niente

Una frase che mi capita spesso di sentire è più o meno questa: “Noi potremmo organizzarci meglio e rendere prevedibile il nostro lavoro, ma i tempi di certe operazioni dipendono dagli altri. Non possiamo farci niente.”

Ogni volta che l’ho sentita ho pensato che avrei dovuto scrivere questo articolo. Perché non è vero che non ci si può fare niente: si può fare qualcosa, e anche di abbastanza semplice.

Chiamo fornitore chiunque debba fare qualcosa per me senza che io ne abbia il controllo. Può essere un’azienda esterna, ma anche un collega di un’altra funzione.

Prima di tutto, misurare

Se dipendo da qualcuno che ci mette tanto tempo, la prima cosa da capire è cosa vuol dire quel “tanto”. Se il fornitore non mi dà le sue metriche, le prendo io: è quella che chiamo ‘metrica reciproca’. Misuro il tempo che passa da quando faccio la richiesta a quando ricevo la risposta, e lo faccio abbastanza a lungo da costruire una curva di distribuzione del Lead Time.

Non servono migliaia di dati. Se il fenomeno è consistente, cioè se i tempi restano più o meno sempre nello stesso range, siamo in quello che Taleb chiama Mediocristan. Il Kanban Maturity Model (KMM) offre una regola pratica per verificarlo: il rapporto tra il 98° percentile e la mediana deve stare sotto 5,6. In quel caso una trentina di misurazioni bastano per avere un quadro piuttosto affidabile.

Abbastanza spesso, a misure prese, scopro una cosa banale: il fornitore non è imprevedibile, è semplicemente più lento di quanto dichiara. E lo è in modo costante.

Decidere con i dati

Il riferimento abituale è l’85° percentile: sei volte su sette la risposta arriva entro quel tempo. Il KMM definisce il Lead Time proprio così: se so quando mi serve la consegna, il Lead Time è l’anticipo con cui devo fare l’ordine per aspettarmi di riceverla in tempo.

A questo punto confronto quel valore con il tempo di cui ho bisogno. Se la risposta mi serve più in là dell’85° percentile, la richiesta va in classe di servizio standard: la mando con il giusto anticipo e so che, storicamente, arriverà in tempo. È inutile sollecitare, ed è inutile sorprendersi ogni volta dei tempi lunghi. Li conosco.

Se invece mi serve prima, il rischio di andare lunghi è più alto di quello che posso permettermi, e la richiesta va segnalata come urgente. Più il tempo è stretto, più il rischio è alto, e la distribuzione mi dice esattamente quanto. L’urgenza però deve restare un’eccezione: se tutto arriva urgente, il fornitore smette di crederci. Per questo conviene giocare d’anticipo il più possibile.

Provare a pressare e poi misurare di nuovo

“Va bene, ma allora come facciamo?” A questo punto posso fare un esperimento: pressare il fornitore e vedere cosa succede alla distribuzione. Se si comprime e l’85° percentile rientra nel tempo che mi serve, ho trovato un pattern su cui contare: il pressing diventa strutturale e lo faccio di default. Se non si comprime, ho comunque imparato che quella leva non funziona.

In ogni caso devo continuare a misurare, perché il pressing cambia il sistema. E devo tenere a mente che, se i miei tempi si accorciano, forse sto solo passando davanti agli altri clienti del fornitore: io miglioro, il suo sistema no.

Le misure servono anche a valle. Se a mia volta devo garantire dei tempi a un cliente, interno o esterno, il mio livello di servizio atteso (SLE – Service Level Expectation) deve tenere conto di quello che so del mio fornitore. È inutile promettere cose che so già di non poter mantenere a causa di qualcun altro.

Un caso reale

Con un fornitore con cui c’è una buona collaborazione dovevamo chiudere un progetto. Il fornitore dichiarava di poter finire entro fine febbraio, e per farcela avrebbe dovuto rilasciare circa nove work item a settimana. Gli abbiamo preso le misure, ricostruendole da progetti passati: ne rilasciava tre, in modo piuttosto stabile.

Non potevamo triplicare il suo Throughput, così abbiamo triplicato il tempo e pianificato la consegna per fine aprile. A lui abbiamo continuato a indicare fine febbraio. Abbiamo misurato il Throughput e non il Lead Time, ma con un sistema stabile vale la Legge di Little e il risultato non cambia: circa tre mesi.

Il progetto si è chiuso, come previsto, a fine aprile. La scadenza più stretta non ha accelerato nulla: il fornitore ha tenuto il suo ritmo. Noi però siamo arrivati puntuali, perché avevamo pianificato sui suoi numeri e non sulle sue dichiarazioni.

Successivamente ho condiviso con lui, in modo trasparente, cosa avevamo misurato e cosa avevamo fatto. E lui ha cambiato approccio.

Conclusione

Quindi no, non è vero che non posso farci niente. Come minimo posso misurare, e sapere cosa posso promettere a mia volta. Poi posso giocare d’anticipo, sperimentare il pressing e vedere se cambia qualcosa. E posso portare i dati al fornitore, perché il suo sistema può migliorarlo solo lui.

Chi ha già un sistema Kanban strutturato può fare il passo successivo con le classi di dipendenza, di cui ho scritto nell’articolo Come funziona Kanban: gestire le dipendenze esterne con le classi di dipendenza.

Bibliografia

  1. David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention – 2nd Edition, Kanban University Press, 2021
L’intelligenza artificiale accelera il lavoro, ma il Lead Time è fatto per lo più di attese

Quando mi chiedono che lavoro faccio, e chi me lo chiede non ha chiaro perché serva un consulente per migliorare i flussi di lavoro, parto sempre dall’efficienza di flusso.

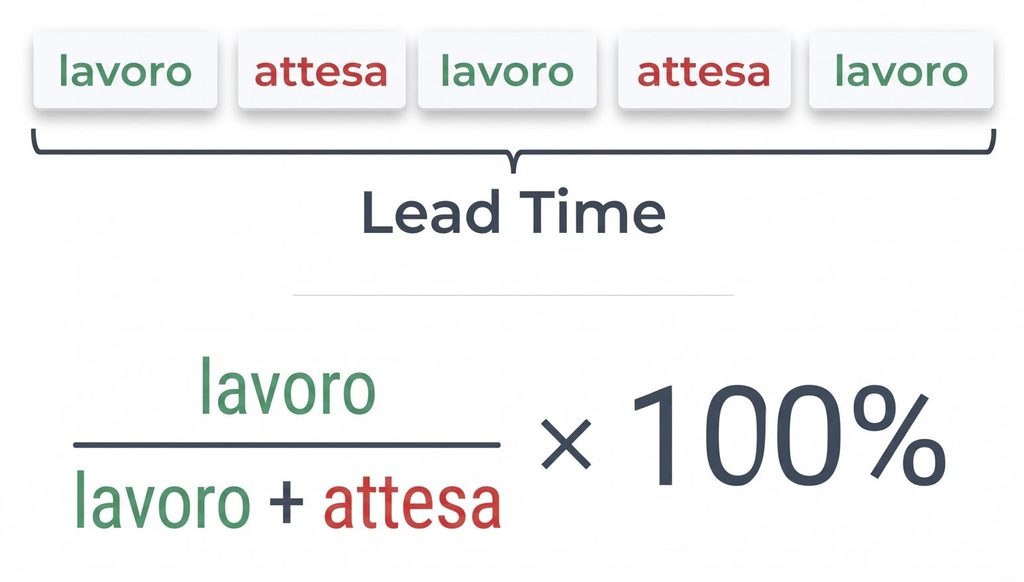
L’efficienza di flusso è il rapporto tra il tempo in cui si lavora effettivamente a un’attività e il tempo totale che passa dall’inizio alla fine di quella stessa attività, cioè il Lead Time. Nella pratica, di solito non si usa come indicatore operativo, perché non è semplice da calcolare. Si usano le pratiche del metodo Kanban, le quali, come risultato, aumentano l’efficienza di flusso. Comprenderne la dinamica, pur senza calcolarla, permette comunque di afferrare il senso del metodo Kanban.

Quando l’efficienza di flusso è bassa, cioè sotto il 15% secondo il Kanban Maturity Model (KMM), il margine di miglioramento sta soprattutto nell’eliminare i tempi di attesa. Il che si ottiene limitando il lavoro in corso, riducendo code e buffer e gestendo meglio problemi bloccanti e dipendenze, tutte pratiche Kanban. Anderson ne ha parlato in un recente keynote, che ho sintetizzato in un articolo. Qui voglio riprendere e approfondire questo specifico aspetto.

Il lavoro effettivo è inizialmente solo una piccola parte del tempo

Il Toyota Production System, precursore del metodo Kanban, ha messo al centro proprio questo: non far andare più veloci gli addetti all’assemblaggio dei veicoli, ma eliminare le attese che stanno intorno al lavoro vero e proprio.

Nel lavoro di concetto, knowledge work in inglese, il ragionamento è identico, con una differenza. La materia prima è l’informazione. Se si parte senza averla tutta e questa arriva un po’ per volta, ci si ferma ad aspettarla, si riparte, ci si ferma di nuovo.

Prendiamo lo sviluppo software. Si comincia a sviluppare e a un certo punto manca un requisito del cliente, perché non era chiaro in fase di analisi. Si chiede al cliente, poi ci si ferma e si aspetta. Quando si ha la risposta, si riprende a lavorare fino a quando si incappa in un altro requisito poco chiaro e ci si ferma di nuovo. E così via. Alla fine il software è pronto, lo si consegna al cliente per il test e si resta in attesa del suo feedback. Se si sommano le attese, nell’esperienza mia e di molti colleghi della community Kanban, queste costituiscono la parte largamente prevalente del Lead Time.

Andare più veloci non è la leva

Per questo, all’inizio di una consulenza, una delle prime cose su cui lavoro è smontare l’idea, diffusa, che l’efficienza si ottenga facendo lavorare più in fretta le persone.

Il punto è controintuitivo. Limitare il lavoro in corso significa che le persone si occupano di meno cose contemporaneamente. Nella mia esperienza questo le porta a ricavarsi il tempo per riflettere su come tagliare i tempi morti, e dopo un po’ il processo va più veloce, senza che nessuno debba affannarsi. Nelle organizzazioni di cui parlo nei miei case study ho visto riduzioni del Lead Time fino al 90%, risultati che sono analoghi a quelli riscontrati da colleghi della community.

Cosa c’entra l’intelligenza artificiale

A più di un lettore può essere venuto a questo punto il dubbio: ma cosa c’entra questo ragionamento con l’intelligenza artificiale? Oggi, nel lavoro di concetto, l’AI viene usata soprattutto per la produttività personale. Aiuta a scrivere un testo, a fare calcoli, a preparare un’analisi, a sviluppare codice, e ognuno di questi compiti si svolge più in fretta.

Ma applicare l’AI a queste attività risponde alla stessa logica del far andare più veloci le persone. Accelera il lavoro effettivo, che è la parte più piccola del Lead Time.

Un esempio numerico: supponiamo che il lavoro effettivo sia il 10% del Lead Time, quindi due giorni su venti, e che l’AI lo dimezzi. Il lavoro passa a un giorno, il Lead Time a diciannove giorni, con un miglioramento del 5%. Il 10% è un’ipotesi esemplificativa, in linea con una situazione sotto la soglia del 15% del KMM, che è l’ordine di grandezza da cui partono i casi che seguo. Il dimezzamento del lavoro effettivo è generoso, per cui nella realtà il miglioramento è probabilmente inferiore.

A fronte di un miglioramento di questa entità, il costo dell’AI può essere anche rilevante, come riferito nel keynote da Anderson. Tornando all’esempio del software: se l’AI fa scrivere il codice più in fretta, il collo di bottiglia resta la risposta del cliente, e il problema non è risolto.

Serve un uso sistemico dell’intelligenza artificiale

La domanda giusta è come si potrebbe usare l’AI per ridurre le attese, che sono ciò che incide davvero sul Lead Time. Personalmente, un uso sistemico di questo tipo non l’ho ancora visto.

Se e quando lo troveremo, otterremo più valore dall’investimento. Anche questo ragionamento conferma però un tema che ho già sollevato in miei articoli precedenti: serve qualcuno che pensi a come gestire il sistema di lavoro e gli strumenti, l’AI compresa. Questo compito non viene eliminato dall’intelligenza artificiale, e continua a essere necessario come lo è sempre stato.