ITIL5 e le metriche del ciclo di vita: dove entra Kanban e dove serve l’intelligenza artificiale

Ho appena terminato di tenere un corso ITIL 5 Foundation. Mentre raccontavo le otto attività del nuovo ciclo di vita dei prodotti e dei servizi, a ciascuna era associato un elenco di metriche di successo, e continuavo a vedere passare metriche che conosco molto bene: sono quelle tipiche dei sistemi Kanban. Avrei voluto fermarmi a raccontare cosa dice il Kanban Maturity Model (KMM) su quelle misure. Chi segue un corso come questo spesso vorrebbe anche capire come si fa nella pratica, ma un corso ITIL deve attenersi al contenuto dell’esame e non è il luogo per approfondire la parte pratica. Allora provo a farlo in questo articolo, almeno per dare qualche spunto.

Un secondo punto mi ha fatto riflettere durante il corso. ITIL 5 collega l’intelligenza artificiale alla visione olistica, quella che in Kanban chiamiamo visione sistemica (Systems Thinking), e all’individuazione dei colli di bottiglia, e dice che i miglioramenti del flusso vanno concentrati proprio lì. È un buon punto di partenza. Io ci aggiungo dove applicarla concretamente: a monte del collo di bottiglia intasa ancora di più, a valle accelera qualcosa che non ne ha bisogno. In aula ho fatto un breve accenno al concetto, qui vorrei provare a spiegarlo meglio.

Cosa introduce ITIL 5

ITIL 5 introduce un modello di ciclo di vita di prodotti e servizi digitali con otto attività: Discover, Design, Acquire, Build, Transition, Operate, Deliver, Support. ITIL precisa che non vanno eseguite come un ciclo: dal punto di vista dell’organizzazione formano la catena del valore, cioè l’insieme delle attività che abilitano il valore. Ogni organizzazione ne include alcune o tutte e le combina, secondo il proprio contesto, nei flussi del valore (value stream).

La novità rispetto a ITIL 4 è che a ciascuna attività è associato un elenco di metriche chiave di successo. In ITIL 4 le metriche stavano nelle pratiche. Cycle time, wait time e lead time c’erano già, ma a livello di flusso e di pratiche, non di attività.

Guardando l’insieme delle metriche, alcune saltano all’occhio. La soddisfazione compare in tutte e otto le attività: quella degli stakeholder in sette, quella di clienti e utenti in Deliver e in Support. L’aderenza alla roadmap o alla strategia in sette. Un tempo esplicito compare in quattro: Design, Acquire, Build e Transition, a cui si aggiunge la velocità di ripristino in Support. Discover, Operate e Deliver non hanno nessuna metrica di tempo.

Le metriche e il Kanban Maturity Model

Le corrispondenze con il KMM sono molte.

Per la transizione ITIL misura il numero e l’impatto degli errori di transizione, cioè dei rilasci andati male. Un rilascio andato male genera rilavorazioni, e il lavoro che ne nasce nel KMM si chiama failure demand: la domanda che arriva perché la qualità iniziale non bastava.

Per la qualità ITIL misura specifiche, risorse e soluzioni. Nel KMM la qualità si misura sul risultato finale: la quota di richieste consegnate senza rilavorazione. Quando si registra una rilavorazione, occorre risalire a quali specifiche, risorse o soluzioni l’hanno generata.

Per Deliver e Support ITIL misura la performance rispetto agli SLA concordati. Nel KMM corrispondono la puntualità di consegna e gli impegni di servizio basati sui percentili di lead time.

Per la soddisfazione di stakeholder, clienti e utenti ITIL ha una misura in ogni attività. Nel KMM corrispondono gli indicatori di fitness for purpose, ricavati dai criteri con cui il cliente sceglie il servizio.

Poi in ITIL troviamo le metriche di tempo: design cycle time, acquire cycle time, building cycle, transition cycle e velocità di ripristino. Nel KMM le grandezze corrispondenti sono lead time e cycle time, che si leggono come percentili sulle rispettive curve di distribuzione.

Cosa ITIL 5 dice sul livello operativo

ITIL 5 fornisce la cornice concettuale, il modello di ciclo di vita e i principi guida per orientare le decisioni, e lascia il dettaglio delle procedure operative ad altre fonti: le ITIL Practice Guide ufficiali, DevOps, PRINCE2 per il project management. Lo stesso ITIL dichiara che nessun framework da solo basta. Tratta anche il flusso, con la mappatura dei flussi del valore, e usa le metriche di tempo per individuare colli di bottiglia e ritardi.

Su Kanban dice due cose. Lo definisce come un metodo per visualizzare il lavoro, individuare blocchi e conflitti di risorse e gestire il lavoro in corso. E cita le Kanban board tra gli strumenti per dare visibilità agli stakeholder. Non compaiono né il funzionamento pull né i limiti al lavoro in corso. A mio avviso la rappresentazione che ITIL offre di Kanban è semplificata, come già scrivevo a proposito di ITIL 4: il metodo è molto più ricco.

Io propongo Kanban per governare e gestire i flussi. Per governare i flussi intendo applicare le pratiche e i principi del metodo Kanban, come specificati nel Kanban Maturity Model. Nel KMM il verbo governare si riferisce alle policy, che regolano il comportamento di persone e team, mentre il flusso di lavoro si gestisce. Io uso i due verbi insieme: le policy governano, e il lavoro scorre e si gestisce dentro quei confini.

Dalle metriche alla pratica

Prendiamo per esempio i rilasci andati male. In ITIL si misura il numero e l’impatto degli errori di transizione. In Kanban ragioniamo per work item, che attraversano il flusso. Se un work item arriva al rilascio e il rilascio va male, viene conteggiato e nasce un nuovo work item, marcato come failure demand: un rifacimento di qualcosa che era già stato fatto. Così facendo sappiamo in ogni momento quanta percentuale complessiva del lavoro è costituita da rilavorazioni.

Quanto possono pesare in percentuale le rilavorazioni? In Kanban: Successful Evolutionary Change for Your Technology Business, David Anderson riporta il caso di un team che spendeva il 90% della capacità disponibile nella correzione di difetti. Un flusso così è intasato da lavoro che nasce da lavoro già fatto male, e le nuove richieste aspettano.

Nelle organizzazioni più mature le rilavorazioni contano contro il limite del lavoro in corso: se ce ne sono troppe, non entra nuovo lavoro finché i problemi di qualità non sono stati risolti. I dati su difetti e rilavorazioni si guardano poi nelle revisioni periodiche, dove si decide cosa fare per ridurli.
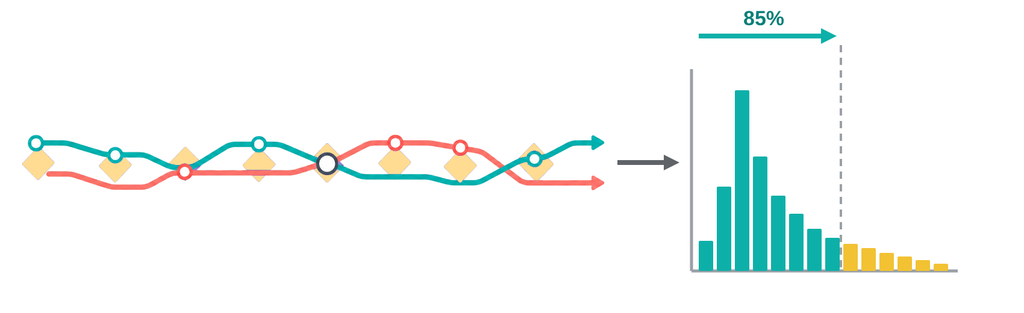
Passiamo alla performance rispetto agli SLA concordati. In Kanban lo SLA si costruisce partendo dai dati: si misurano i lead time dei lavori consegnati e se ne costruisce la curva di distribuzione. Dalla curva si leggono i percentili e, in base al percentile opportuno, si definisce la service level expectation (SLE): entro quanti giorni consegno e in quale percentuale di casi. L’85° percentile è il riferimento abituale, ma non è una regola: se un ritardo costa molto, conviene salire. Sulla base dello SLE definito si concorda lo SLA con il cliente in modo realistico.

Le metriche di tempo che ITIL associa alle attività, cioè design cycle time, acquire cycle time, building cycle e transition cycle, misurano ciascuna un singolo passaggio. ITIL ha poi una misura dell’intero flusso del valore, il lead time, dall’avvio alla consegna, e indica le otto attività come un buon punto di partenza per mappare i flussi. ITIL non dice però da dove parta il lead time.

Il KMM lo precisa, e parla dello stesso oggetto: quello che ITIL chiama flusso del valore, nel KMM è il workflow. Il customer lead time parte dalla richiesta accettata del cliente, il system lead time dalla presa in carico del lavoro da parte del team, ed entrambi arrivano alla consegna. Quando si applica Kanban si misurano sia le metriche end to end sia quelle dei singoli passaggi, e anche le attese, e in base a queste misure si ragiona su come ottimizzare il flusso.

Un passaggio può avere un buon tempo di ciclo e il cliente aspettare comunque a lungo, perché nel tempo di ciclo non ci sono le attese tra un passaggio e l’altro. L’esperienza dice che le attese sono la parte prevalente del lead time, e di diversi casi ho scritto anche su questo blog. Per questo si lavora sulle attese: limitando il lavoro in corso, riducendo code e buffer, gestendo meglio blocchi e dipendenze.

Lo stesso vale per la velocità di ripristino del servizio, che in ITIL compare in Support. È il lead time della gestione degli incidenti, e come ogni altra metrica di tempo si misura con la distribuzione, si legge con i percentili e si trasforma in uno SLE.

Resta la soddisfazione di stakeholder, clienti e utenti, che ITIL misura in tutte e otto le attività. Nel KMM non la si misura chiedendola in astratto. Si parte dai criteri con cui il cliente decide se richiedere il servizio, o dalle fonti della sua insoddisfazione, e da lì si ricavano gli indicatori da misurare: tempi di consegna per classe di servizio, quota di richieste consegnate senza rilavorazione, costo.

È quello che facciamo in continuazione con le aziende con cui collaboro. Partiamo dalle fonti di insoddisfazione, che mi raccontano i clienti. Quando abbiamo messo a posto il servizio, verifichiamo se quelle fonti sono state risolte. Gli indicatori non sono necessariamente solo quelli classici di Kanban: dalle fonti di insoddisfazione possono emergere altri aspetti da misurare, e li misuriamo. In questo modo la fitness for purpose diventa la sintesi di tutte le metriche, classiche e no.

L’intelligenza artificiale: dove serve e dove no

ITIL 5 dedica molto spazio all’intelligenza artificiale, e la collega alla visione olistica e all’individuazione dei colli di bottiglia. Dice anche di concentrare i miglioramenti del flusso proprio sui colli di bottiglia, e di ottimizzare il flusso prima di automatizzarlo. È un buon punto di partenza.

Una volta definito il flusso, si misura e si individua il collo di bottiglia, ed è lì che va applicata l’AI. Se la si applica a monte, il lavoro si accumula davanti al collo di bottiglia e il lead time peggiora. Se la si applica a valle, il lead time non cambia in modo apprezzabile, e può essere anche uno spreco: si accelera una stazione di lavoro che è già più scarica del collo di bottiglia. Prendiamo uno sviluppo software: se l’AI fa scrivere il codice più in fretta, ma il collo di bottiglia, a monte, è la risposta del cliente sui requisiti poco chiari, il lavoro accelerato resta in attesa. Non è cambiato nulla.

C’è poi un secondo ragionamento. Spesso il lavoro è fatto per lo più di attese, e accelerare il lavoro effettivo, come fa l’AI quando velocizza un compito, cambia poco il lead time. Ne ho scritto in un articolo recente, e lì la domanda diventa un’altra: come usare l’AI per ridurre le attese.

Conclusione

Sono partito da ITIL 5, che dice cosa misurare per ciascuna attività del ciclo di vita e rimanda ad altre fonti per il dettaglio operativo. Io propongo Kanban per governare e gestire i flussi, e le metriche sono il punto da cui si comincia. I rilasci andati male diventano failure demand, gli SLA nascono dalla distribuzione dei lead time, la soddisfazione si ricava dalle fonti di insoddisfazione di chi usa il servizio, e le metriche di tempo si leggono su tutto il flusso, non solo su un singolo passaggio.

Anche per l’intelligenza artificiale vale lo stesso ragionamento: serve dove c’è il collo di bottiglia, non dove il lavoro è già veloce. E resta necessario qualcuno che gestisca il sistema di lavoro, AI compresa.

Bibliografia

  1. ITIL® Foundation, Version 5, manuale ufficiale, e ITIL® (Versione 5) Glossario principale, v5.1, luglio 2026, PeopleCert.
  2. David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention, 2nd Edition, Kanban University Press, 2021.
  3. David J. Anderson, Kanban: Successful Evolutionary Change for Your Technology Business, Blue Hole Press, 2010.
Pillole di Kanban applicato: la gestione dell’imbarco e dello sbarco in aereo

Tornando dal Kanban Leadership Retreat di Bilbao ho volato con Vueling, sulle tratte Bilbao-Barcellona e Barcellona-Milano. Due imbarchi e due sbarchi, sempre con la stessa gestione del flusso. Cito la compagnia perché è quella che ho potuto osservare, non perché sia l’unica. Qui voglio soffermarmi su cosa possiamo imparare da questo modo di gestire il flusso dei passeggeri, per applicarlo ai flussi di lavoro delle nostre organizzazioni.

Il vincolo: una sola porta

In tutti e quattro i casi l’aereo era attraccato al pontile, il cosiddetto finger. In questa situazione si usa solo la porta anteriore e quella posteriore resta chiusa. Per i passeggeri è più comodo, perché si resta sempre all’interno, non si cammina mai in pista e non ci si bagna se piove.

Imbarco e sbarco però sono normalmente più lenti, perché tutti passano da una sola porta. Se chi ha la fila 26 si trova dietro a chi ha la fila 4, deve fermarsi finché l’altro non si è seduto, perché non c’è spazio per proseguire. In termini Kanban, la porta è il collo di bottiglia del sistema.

Diventa quindi fondamentale l’ordine di imbarco. Le compagnie da sempre chiamano per numero di fila, ma i passeggeri fanno un po’ quello che vogliono. Qualcuno arriva con la fila sbagliata e viene messo da parte, ma non si sottilizza troppo, e all’imbarco si crea di solito parecchia confusione.

All’imbarco: corsie, cartelli e gruppi

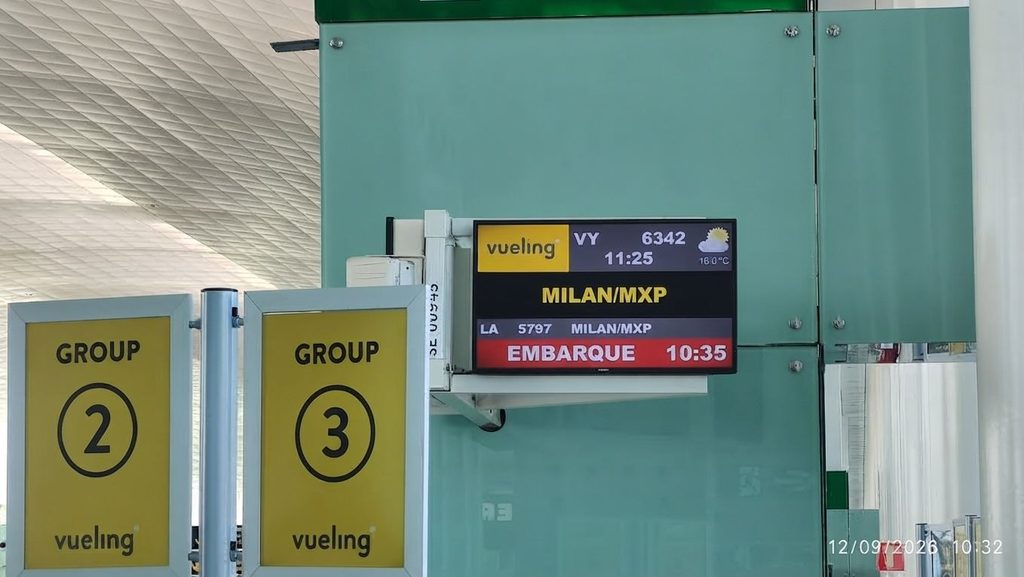
Nei gate che ho usato, Vueling divide i passeggeri in tre gruppi, anteriore, centrale e posteriore. È un sistema semplice, come si fa nel metodo Kanban, senza niente di sofisticato. Il numero del gruppo, 1, 2 o 3, è stampato sulla carta d’imbarco.

Al gate le transenne a nastro, le cosiddette bindelle, creano tre corsie di coda, ciascuna con il suo cartello. Le persone si mettono quasi spontaneamente nella corsia giusta. Si imbarca il gruppo 1, poi il 2, poi il 3, e il gruppo successivo viene chiamato quando il precedente è sostanzialmente imbarcato.

Non è molto diverso da quello che si è sempre fatto, ma creando le corsie e mettendo i cartelli si gestisce davvero il flusso, e l’ingresso in aereo risulta molto più ordinato. Ritrovo la visualizzazione (corsie e cartelli), una policy esplicita (il gruppo sulla carta d’imbarco), il limite al lavoro in corso (si imbarca un gruppo alla volta) e il pull (il gruppo successivo viene chiamato quando il precedente ha finito).

Io ero nel gruppo 3, perché avevo preso la tariffa più economica. Quando sono salito, i gruppi 1 e 2, cioè circa due terzi dell’aereo, erano già seduti e il corridoio era libero. Andare in fondo e sedersi è stato molto più semplice. È successo sia a Bilbao sia a Barcellona.

Allo sbarco: un sistema simile

Ho fatto due sbarchi, a Barcellona e a Milano. Di solito, quando l’aereo arriva all’attracco, tutti i passeggeri saltano in piedi e cominciano a tirare fuori i bagagli dalle cappelliere. Qui invece parte un annuncio abbastanza perentorio: restare seduti al proprio posto fino a quando non si viene chiamati.

Poi si chiamano blocchi di file, partendo dalle più avanti, dalla 1 alla X e poi dalla X+1 alla Y. Non ricordo quante file avesse ogni blocco. Il personale tiene monitorato il deflusso e, quando il blocco è pronto a uscire, chiama il successivo. L’uscita risulta più ordinata e più rapida.

Anche qui ritrovo una policy esplicita (restare seduti), il limite al lavoro in corso (un blocco alla volta) e il pull, con il segnale che arriva da valle, cioè dal corridoio che si sta liberando. Sono due sistemi diversi ma simili e governati dalle stesse logiche di gestione del flusso: uno per l’imbarco, uno per lo sbarco.

Le misure

Sono rimasto favorevolmente impressionato, perché è un esempio semplice di come un accorgimento facile da implementare possa migliorare un flusso. La mia sensazione è che il tempo di imbarco e sbarco si sia ridotto sensibilmente. Non ho fatto misure, perché l’idea dell’articolo mi è venuta dopo il viaggio, quindi non ho né i tempi né il numero di file per gruppo di imbarco o blocco di sbarco. In ogni caso le mie misure non sarebbero state significative come statistica.

Le compagnie aeree le misure le fanno di sicuro. Hanno tempi stretti per sbarcare, imbarcare e non perdere lo slot di decollo, come detto chiaramente negli annunci che mi è capitato di sentire altre volte per sollecitare i passeggeri a sbrigarsi a prendere posto. Non so cosa misurino esattamente, ma suppongo che tra le misure ci siano il tempo tra l’apertura delle porte e lo sbarco completo, e il tempo tra l’apertura del gate e la chiusura delle porte.

Suppongo anche che il sistema sia stato ottimizzato: con una sola porta, in pochi minuti l’aereo era pronto a partire.

Cosa portarsi a casa

Per i nostri flussi di lavoro la lezione è la stessa: rendere visibile il flusso, esplicitare le regole e far entrare il lavoro a blocchi, chiamando il successivo solo quando il precedente sta defluendo. Nel vostro sistema, in base a cosa si decide quando il blocco successivo può partire?

CONWIP vs. Drum-Buffer-Rope (DBR): scegliere lo strumento giusto in base alla maturità organizzativa

Durante il recente PMexpo ho riproposto il workshop Dal caos al flusso – sbloccare il potenziale del tuo team con Kanban. Gestire un laboratorio pratico sulla gestione del flusso con Kanban, con circa 40 partecipanti e un’ora e mezza di tempo a disposizione, è una sfida ma anche un’ottima opportunità per far toccare con mano a un pubblico ampio le dinamiche del flusso di lavoro. Abbiamo potuto verificare in modo empirico quanto sia immediato migliorare la produttività applicando la pratica di limitare il lavoro in corso: i partecipanti hanno osservato un incremento di produttività del 50%.

Sempre al PMexpo, in un interessante keynote speech della mattinata dal titolo molto simile – Le Regole del Flusso: dal caos alla gestione efficace negli ambienti multi-progetto – Efrat Goldratt-Ashlag e Gianluca Davico hanno mostrato come la Teoria dei Vincoli (TOC) possa essere applicata per riportare ordine, efficacia e risultati concreti negli ambienti multi-progetto.

Nel metodo Kanban si fa uso di entrambi gli approcci, e questo mi ha portato a una riflessione che voglio approfondire nel seguito dell’articolo: limitare il numero complessivo degli elementi di lavoro presenti nel sistema di flusso – ciò che più avanti definirò come CONWIP – rappresenta la soluzione per far evolvere, nelle prime fasi, le organizzazioni meno strutturate. La Teoria dei Vincoli (TOC), con il suo modello Drum-Buffer-Rope (DBR) – di cui ho già parlato in un precedente articolo – consente invece di gestire sistemi di flusso più maturi e complessi, permettendo di sfruttare in modo sempre più efficace i vincoli man mano che l’organizzazione cresce in capacità e consapevolezza.

Oltre la semplice scelta di uno strumento di pull

Sia il CONWIP (Constant Work-In-Progress) che il Drum-Buffer-Rope (DBR) sono potenti meccanismi di sistema pull (a chiamata), progettati per gestire il flusso di lavoro e migliorare le performance. Tuttavia, il loro utilizzo non è intercambiabile. Sebbene entrambi mirino a creare un flusso più stabile e prevedibile, operano a livelli di complessità e maturità organizzativa diversi. Applicare lo strumento sbagliato al contesto sbagliato può portare a frustrazione e insuccesso; al contrario, allineare la pratica al livello di maturità dell’organizzazione è un passo fondamentale verso un cambiamento evolutivo di successo. Prima di decidere quando utilizzarli, è imperativo comprendere cosa sono e per quale problema fondamentale sono stati progettati.

Definizione e concetti chiave

Per confrontare efficacemente CONWIP e DBR, è essenziale prima comprendere la loro definizione fondamentale e il loro scopo primario all’interno di un sistema di gestione del flusso di lavoro. Sebbene entrambi limitino il lavoro in corso, il loro focus e il meccanismo di controllo sono radicalmente diversi e rispondono a problemi distinti.

CONWIP: stabilire un limite a livello di sistema

Il sistema CONWIP (Constant Work-In-Progress), descritto nella pratica LW 2.1 del KMM, stabilisce un limite al numero totale di elementi di lavoro all’interno dell’intero sistema, indipendentemente dal loro stato specifico. Questo crea un sistema pull di base in cui un nuovo elemento di lavoro può entrare nel flusso solo quando un altro è stato completato e consegnato.

Il KMM lo descrive come un proto-kanban system, sottolineando che mantiene un controllo meno granulare sui singoli stati del flusso di lavoro rispetto a un sistema Kanban più maturo. Tuttavia, la sua forza risiede nella semplicità e nell’efficacia nel ridurre il sovraccarico dell’intero sistema, fornendo al team un primo, potente strumento per gestire il flusso end-to-end e alleviare la pressione generale.

DBR (Drum-Buffer-Rope): ottimizzare sfruttando un collo di bottiglia

Il Drum-Buffer-Rope (DBR), descritto nella pratica IE 5.4 del KMM, è un sistema pull molto più sofisticato, nato come meccanismo di implementazione pratica della Teoria dei Vincoli (TOC). È progettato specificamente per ottimizzare un sistema attorno al suo collo di bottiglia. Il suo meccanismo fondamentale è quello di regolare l’intero sistema in base al ritmo del suo vincolo principale.

Il meccanismo si basa su tre componenti:

  • Drum (Tamburo): il ritmo di lavoro del collo di bottiglia, che determina la velocità massima dell’intero sistema.
  • Buffer (Cuscinetto): una scorta di lavoro posizionata strategicamente subito prima del collo di bottiglia per garantirne il pieno sfruttamento e proteggerlo da interruzioni a monte.
  • Rope (Corda): il segnale che “chiama” nuovo lavoro nel sistema, permettendone l’ingresso solo al ritmo con cui il “Drum” completa il lavoro.

Lo scopo del DBR è di eseguire i passi chiave della TOC: “sfruttare” il vincolo e “subordinare” tutte le altre attività nel flusso di lavoro per proteggerne la capacità, massimizzando così il throughput complessivo.

Questi due approcci, come vedremo, trovano la loro collocazione ideale in fasi molto diverse del percorso evolutivo di un’organizzazione.

Il ruolo decisivo della maturità organizzativa

La scelta tra CONWIP e DBR non è una questione di preferenza tecnica, ma una decisione strategica dettata dal livello di evoluzione e comprensione che un’organizzazione ha dei propri processi. Il loro posizionamento distinto all’interno del Kanban Maturity Model (KMM) evidenzia come l’adozione di determinate pratiche debba essere allineata al livello di maturità raggiunto, per evitare di introdurre una complessità che l’organizzazione non è ancora pronta a gestire.

CONWIP: uno strumento per la maturità di livello 2 (ML2)

Un’organizzazione a livello di maturità 2 (ML2) è descritta nel KMM come “Customer-Driven”. In questa fase, il flusso di lavoro è emergente e, sebbene i processi siano consistenti, i risultati non lo sono ancora, portando a una situazione caratterizzata dall’espressione “mai due volte lo stesso risultato”. La sfida principale è alleviare un sovraccarico sistemico e indifferenziato, dove il vincolo principale non è ancora noto o è in continuo rapido mutamento.

In questo contesto, il CONWIP emerge come pratica di consolidamento ideale. È uno strumento appropriato perché l’organizzazione non è ancora in grado di attuare un’ottimizzazione sistematica. Come nota il KMM, a ML2 “l’organizzazione si affida a manager eroici per accelerare le richieste importanti dei clienti“. I clienti imparano a fidarsi di specifici manager, non ancora dell’organizzazione o dei suoi sistemi. Un meccanismo di controllo semplice e a livello di sistema come il CONWIP è perfetto per:

  • Introdurre un sistema pull di base senza richiedere una mappatura granulare.
  • Fornire un sollievo immediato dal sovraccarico generale.
  • Aiutare l’organizzazione a iniziare a gestire il flusso end-to-end, un passo cruciale per evolvere oltre il focus sui singoli team tipico invece di ML1.

DBR: una pratica avanzata per la maturità di livello 5 (ML5)

Un’organizzazione a livello di maturità 5 (ML5) è descritta come “Market Leader”. A questo livello, l’organizzazione è caratterizzata da una “ricerca incessante della perfezione” e da un’ottimizzazione continua dell’efficienza e delle performance economiche. Possiede un’agilità derivante da un design organizzativo orientato ai servizi ed è in grado di riconfigurarsi prontamente per offrire nuovi servizi. Ha una profonda comprensione quantitativa del proprio sistema stabile e dei propri processi.

Il DBR è una pratica di consolidamento ML5 proprio perché la sua implementazione richiede questo livello di maturità. L’organizzazione ha la capacità di identificare un vincolo unico, sufficientemente persistente e definito che limita le performance dell’intero sistema. Il DBR non è solo una soluzione a un collo di bottiglia; è uno strumento strategico utilizzato da un’organizzazione altamente adattabile per:

  • Sfruttare un vincolo identificato con precisione per massimizzare il throughput.
  • Subordinare disciplinatamente tutte le altre attività a quell’unico vincolo.
  • Allineare l’intero sistema a un obiettivo di ottimizzazione economica, consolidando la propria leadership di mercato.

La scelta, quindi, non dipende solo da quando nel percorso di maturità, ma anche dal perché, ovvero dalla natura del problema che l’organizzazione sta affrontando.

Circostanze d’uso e problemi risolti

Oltre al livello di maturità, le circostanze specifiche e il problema che si sta cercando di risolvere sono determinanti per la scelta corretta dello strumento. CONWIP e DBR sono progettati per affrontare sfide fondamentalmente diverse: la prima mira alla stabilizzazione, la seconda allo sfruttamento.

Quando usare CONWIP: stabilizzare il sistema per gestire il sovraccarico indefinito

Il CONWIP è la scelta ideale quando il problema principale è un sovraccarico generale e non differenziato del sistema, piuttosto che un singolo punto di blocco chiaramente identificato.

Scenario tipico:

  • Un’organizzazione sta passando da un focus sui team (ML1) a un focus sul servizio (ML2).
  • Il flusso di lavoro end-to-end è ancora in fase di definizione (“emergente“).
  • La sensazione prevalente è che “tutto è una priorità” e le persone sono costantemente sovraccariche, ma non è chiaro quale sia il vero vincolo.

In queste circostanze, l’obiettivo primario non è ottimizzare, ma stabilizzare. CONWIP introduce un segnale di pull a livello di sistema che costringe l’organizzazione a finire il lavoro prima di iniziarne di nuovo. Questo riduce il multitasking e permette di creare le condizioni di base per comprendere il sistema e iniziare a misurare un lead time più significativo.

Quando usare DBR: sfruttare un collo di bottiglia definito

Il DBR è appropriato quando l’organizzazione ha raggiunto una comprensione del proprio processo, al punto da aver identificato un collo di bottiglia chiaro e persistente che limita le performance dell’intero sistema.

Scenario tipico:

  • L’organizzazione ha già un flusso di lavoro stabile e prevedibile (ML3/ML4).
  • L’analisi quantitativa dei dati di flusso (es. diagrammi di flusso cumulativo) mostra un accumulo costante di lavoro in una fase specifica.
  • L’obiettivo è aumentare il throughput complessivo agendo in modo mirato su quel singolo vincolo.

In questo scenario, l’obiettivo è sfruttare il vincolo noto per massimizzare il throughput totale. Il DBR fornisce il meccanismo per garantire che il collo di bottiglia non sia mai inattivo (grazie al buffer) e che il resto del sistema non lo sovraccarichi (grazie alla corda), ottimizzando così l’intero sistema attorno al suo punto di leva più efficace. Se il vincolo si sposta, il sistema DBR viene ricalibrato per sfruttare il nuovo vincolo e mantenere il flusso nelle migliori condizioni di performance. Un sistema così equilibrato e ottimizzato può poi essere “elevato” per aumentarne la capacità produttiva.

Conclusione: maturità e contesto guidano la scelta

La scelta tra CONWIP e DBR deve essere una decisione informata, guidata da una valutazione onesta della maturità organizzativa e della natura del problema specifico che si intende risolvere. Il CONWIP è uno strumento di stabilizzazione per un’organizzazione ML2 che affronta un sovraccarico sistemico e indifferenziato. Il DBR è uno strumento di sfruttamento per un’organizzazione ML5 che ha identificato un vincolo definito e possiede la disciplina per ottimizzare l’intero sistema attorno ad esso.

Tentare di implementare il DBR in un’organizzazione a bassa maturità, senza una chiara comprensione del flusso e dei suoi vincoli, è una soluzione rischiosa. Allo stesso modo, limitarsi al CONWIP quando si è raggiunto un maggiore livello di maturità e si ha un chiaro collo di bottiglia, significa lasciare sul tavolo significative opportunità di miglioramento. L’applicazione dello strumento giusto al momento giusto non è solo un principio fondamentale del cambiamento evolutivo, ma un passo cruciale verso il raggiungimento di una maggiore agilità, resilienza e performance aziendale.