Ho appena terminato di tenere un corso ITIL 5 Foundation. Mentre raccontavo le otto attività del nuovo ciclo di vita dei prodotti e dei servizi, a ciascuna era associato un elenco di metriche di successo, e continuavo a vedere passare metriche che conosco molto bene: sono quelle tipiche dei sistemi Kanban. Avrei voluto fermarmi a raccontare cosa dice il Kanban Maturity Model (KMM) su quelle misure. Chi segue un corso come questo spesso vorrebbe anche capire come si fa nella pratica, ma un corso ITIL deve attenersi al contenuto dell’esame e non è il luogo per approfondire la parte pratica. Allora provo a farlo in questo articolo, almeno per dare qualche spunto.
Un secondo punto mi ha fatto riflettere durante il corso. ITIL 5 collega l’intelligenza artificiale alla visione olistica, quella che in Kanban chiamiamo visione sistemica (Systems Thinking), e all’individuazione dei colli di bottiglia, e dice che i miglioramenti del flusso vanno concentrati proprio lì. È un buon punto di partenza. Io ci aggiungo dove applicarla concretamente: a monte del collo di bottiglia intasa ancora di più, a valle accelera qualcosa che non ne ha bisogno. In aula ho fatto un breve accenno al concetto, qui vorrei provare a spiegarlo meglio.
Cosa introduce ITIL 5
ITIL 5 introduce un modello di ciclo di vita di prodotti e servizi digitali con otto attività: Discover, Design, Acquire, Build, Transition, Operate, Deliver, Support. ITIL precisa che non vanno eseguite come un ciclo: dal punto di vista dell’organizzazione formano la catena del valore, cioè l’insieme delle attività che abilitano il valore. Ogni organizzazione ne include alcune o tutte e le combina, secondo il proprio contesto, nei flussi del valore (value stream).
La novità rispetto a ITIL 4 è che a ciascuna attività è associato un elenco di metriche chiave di successo. In ITIL 4 le metriche stavano nelle pratiche. Cycle time, wait time e lead time c’erano già, ma a livello di flusso e di pratiche, non di attività.
Guardando l’insieme delle metriche, alcune saltano all’occhio. La soddisfazione compare in tutte e otto le attività: quella degli stakeholder in sette, quella di clienti e utenti in Deliver e in Support. L’aderenza alla roadmap o alla strategia in sette. Un tempo esplicito compare in quattro: Design, Acquire, Build e Transition, a cui si aggiunge la velocità di ripristino in Support. Discover, Operate e Deliver non hanno nessuna metrica di tempo.
Le metriche e il Kanban Maturity Model
Le corrispondenze con il KMM sono molte.
Per la transizione ITIL misura il numero e l’impatto degli errori di transizione, cioè dei rilasci andati male. Un rilascio andato male genera rilavorazioni, e il lavoro che ne nasce nel KMM si chiama failure demand: la domanda che arriva perché la qualità iniziale non bastava.
Per la qualità ITIL misura specifiche, risorse e soluzioni. Nel KMM la qualità si misura sul risultato finale: la quota di richieste consegnate senza rilavorazione. Quando si registra una rilavorazione, occorre risalire a quali specifiche, risorse o soluzioni l’hanno generata.
Per Deliver e Support ITIL misura la performance rispetto agli SLA concordati. Nel KMM corrispondono la puntualità di consegna e gli impegni di servizio basati sui percentili di lead time.
Per la soddisfazione di stakeholder, clienti e utenti ITIL ha una misura in ogni attività. Nel KMM corrispondono gli indicatori di fitness for purpose, ricavati dai criteri con cui il cliente sceglie il servizio.
Poi in ITIL troviamo le metriche di tempo: design cycle time, acquire cycle time, building cycle, transition cycle e velocità di ripristino. Nel KMM le grandezze corrispondenti sono lead time e cycle time, che si leggono come percentili sulle rispettive curve di distribuzione.
Cosa ITIL 5 dice sul livello operativo
ITIL 5 fornisce la cornice concettuale, il modello di ciclo di vita e i principi guida per orientare le decisioni, e lascia il dettaglio delle procedure operative ad altre fonti: le ITIL Practice Guide ufficiali, DevOps, PRINCE2 per il project management. Lo stesso ITIL dichiara che nessun framework da solo basta. Tratta anche il flusso, con la mappatura dei flussi del valore, e usa le metriche di tempo per individuare colli di bottiglia e ritardi.
Su Kanban dice due cose. Lo definisce come un metodo per visualizzare il lavoro, individuare blocchi e conflitti di risorse e gestire il lavoro in corso. E cita le Kanban board tra gli strumenti per dare visibilità agli stakeholder. Non compaiono né il funzionamento pull né i limiti al lavoro in corso. A mio avviso la rappresentazione che ITIL offre di Kanban è semplificata, come già scrivevo a proposito di ITIL 4: il metodo è molto più ricco.
Io propongo Kanban per governare e gestire i flussi. Per governare i flussi intendo applicare le pratiche e i principi del metodo Kanban, come specificati nel Kanban Maturity Model. Nel KMM il verbo governare si riferisce alle policy, che regolano il comportamento di persone e team, mentre il flusso di lavoro si gestisce. Io uso i due verbi insieme: le policy governano, e il lavoro scorre e si gestisce dentro quei confini.
Dalle metriche alla pratica
Prendiamo per esempio i rilasci andati male. In ITIL si misura il numero e l’impatto degli errori di transizione. In Kanban ragioniamo per work item, che attraversano il flusso. Se un work item arriva al rilascio e il rilascio va male, viene conteggiato e nasce un nuovo work item, marcato come failure demand: un rifacimento di qualcosa che era già stato fatto. Così facendo sappiamo in ogni momento quanta percentuale complessiva del lavoro è costituita da rilavorazioni.
Quanto possono pesare in percentuale le rilavorazioni? In Kanban: Successful Evolutionary Change for Your Technology Business, David Anderson riporta il caso di un team che spendeva il 90% della capacità disponibile nella correzione di difetti. Un flusso così è intasato da lavoro che nasce da lavoro già fatto male, e le nuove richieste aspettano.
Nelle organizzazioni più mature le rilavorazioni contano contro il limite del lavoro in corso: se ce ne sono troppe, non entra nuovo lavoro finché i problemi di qualità non sono stati risolti. I dati su difetti e rilavorazioni si guardano poi nelle revisioni periodiche, dove si decide cosa fare per ridurli.
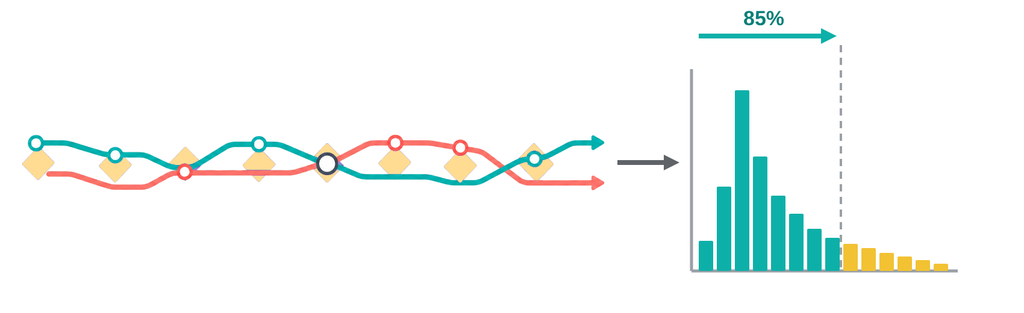
Passiamo alla performance rispetto agli SLA concordati. In Kanban lo SLA si costruisce partendo dai dati: si misurano i lead time dei lavori consegnati e se ne costruisce la curva di distribuzione. Dalla curva si leggono i percentili e, in base al percentile opportuno, si definisce la service level expectation (SLE): entro quanti giorni consegno e in quale percentuale di casi. L’85° percentile è il riferimento abituale, ma non è una regola: se un ritardo costa molto, conviene salire. Sulla base dello SLE definito si concorda lo SLA con il cliente in modo realistico.
Le metriche di tempo che ITIL associa alle attività, cioè design cycle time, acquire cycle time, building cycle e transition cycle, misurano ciascuna un singolo passaggio. ITIL ha poi una misura dell’intero flusso del valore, il lead time, dall’avvio alla consegna, e indica le otto attività come un buon punto di partenza per mappare i flussi. ITIL non dice però da dove parta il lead time.
Il KMM lo precisa, e parla dello stesso oggetto: quello che ITIL chiama flusso del valore, nel KMM è il workflow. Il customer lead time parte dalla richiesta accettata del cliente, il system lead time dalla presa in carico del lavoro da parte del team, ed entrambi arrivano alla consegna. Quando si applica Kanban si misurano sia le metriche end to end sia quelle dei singoli passaggi, e anche le attese, e in base a queste misure si ragiona su come ottimizzare il flusso.
Un passaggio può avere un buon tempo di ciclo e il cliente aspettare comunque a lungo, perché nel tempo di ciclo non ci sono le attese tra un passaggio e l’altro. L’esperienza dice che le attese sono la parte prevalente del lead time, e di diversi casi ho scritto anche su questo blog. Per questo si lavora sulle attese: limitando il lavoro in corso, riducendo code e buffer, gestendo meglio blocchi e dipendenze.
Lo stesso vale per la velocità di ripristino del servizio, che in ITIL compare in Support. È il lead time della gestione degli incidenti, e come ogni altra metrica di tempo si misura con la distribuzione, si legge con i percentili e si trasforma in uno SLE.
Resta la soddisfazione di stakeholder, clienti e utenti, che ITIL misura in tutte e otto le attività. Nel KMM non la si misura chiedendola in astratto. Si parte dai criteri con cui il cliente decide se richiedere il servizio, o dalle fonti della sua insoddisfazione, e da lì si ricavano gli indicatori da misurare: tempi di consegna per classe di servizio, quota di richieste consegnate senza rilavorazione, costo.
È quello che facciamo in continuazione con le aziende con cui collaboro. Partiamo dalle fonti di insoddisfazione, che mi raccontano i clienti. Quando abbiamo messo a posto il servizio, verifichiamo se quelle fonti sono state risolte. Gli indicatori non sono necessariamente solo quelli classici di Kanban: dalle fonti di insoddisfazione possono emergere altri aspetti da misurare, e li misuriamo. In questo modo la fitness for purpose diventa la sintesi di tutte le metriche, classiche e no.
L’intelligenza artificiale: dove serve e dove no
ITIL 5 dedica molto spazio all’intelligenza artificiale, e la collega alla visione olistica e all’individuazione dei colli di bottiglia. Dice anche di concentrare i miglioramenti del flusso proprio sui colli di bottiglia, e di ottimizzare il flusso prima di automatizzarlo. È un buon punto di partenza.
Una volta definito il flusso, si misura e si individua il collo di bottiglia, ed è lì che va applicata l’AI. Se la si applica a monte, il lavoro si accumula davanti al collo di bottiglia e il lead time peggiora. Se la si applica a valle, il lead time non cambia in modo apprezzabile, e può essere anche uno spreco: si accelera una stazione di lavoro che è già più scarica del collo di bottiglia. Prendiamo uno sviluppo software: se l’AI fa scrivere il codice più in fretta, ma il collo di bottiglia, a monte, è la risposta del cliente sui requisiti poco chiari, il lavoro accelerato resta in attesa. Non è cambiato nulla.
C’è poi un secondo ragionamento. Spesso il lavoro è fatto per lo più di attese, e accelerare il lavoro effettivo, come fa l’AI quando velocizza un compito, cambia poco il lead time. Ne ho scritto in un articolo recente, e lì la domanda diventa un’altra: come usare l’AI per ridurre le attese.
Conclusione
Sono partito da ITIL 5, che dice cosa misurare per ciascuna attività del ciclo di vita e rimanda ad altre fonti per il dettaglio operativo. Io propongo Kanban per governare e gestire i flussi, e le metriche sono il punto da cui si comincia. I rilasci andati male diventano failure demand, gli SLA nascono dalla distribuzione dei lead time, la soddisfazione si ricava dalle fonti di insoddisfazione di chi usa il servizio, e le metriche di tempo si leggono su tutto il flusso, non solo su un singolo passaggio.
Anche per l’intelligenza artificiale vale lo stesso ragionamento: serve dove c’è il collo di bottiglia, non dove il lavoro è già veloce. E resta necessario qualcuno che gestisca il sistema di lavoro, AI compresa.
Bibliografia
- ITIL® Foundation, Version 5, manuale ufficiale, e ITIL® (Versione 5) Glossario principale, v5.1, luglio 2026, PeopleCert.
- David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention, 2nd Edition, Kanban University Press, 2021.
- David J. Anderson, Kanban: Successful Evolutionary Change for Your Technology Business, Blue Hole Press, 2010.